Содержание
Тренировочный зал с одними и теми же гантелями не готовит к улице: мышцы привыкают к одному весу и «сдают», едва нагрузка чуть другая. С датасетом то же самое — модель учится не «читать бланки вообще», а узнавать ровно тот вид кропов, который вы ей показали.
Если все вырезки клеток похожи друг на друга, а «пустая» всегда выглядит как чистая бумага без пятен и линий, три следующих шага курса теряют смысл. Сплит по листам (урок 5) сравнивает обучение и проверку, которые выглядят одинаково: утечку стиля листа не видно. Детектор пустых (уроки 7–9) отличает белый квадрат от цифр — задача слишком лёгкая, хватает правила «есть ли чернила», сеть почти ничему не учится. Каскад (урок 18) нечему проверять: нет «грязных» пустых клеток, на которых сторож и читатель должны спорить.
Поэтому у урока две цели. Первая — получить датасет без ручной разметки. Вторая, важнее — заложить в синтетику свойства реальных бланков, на которых потом ловятся ошибки. В уроке 3 мы зафиксировали алфавит и формат. Сегодня серия «Обучаем CNN и CRNN с нуля» собирает данные и сразу слой-адаптер, чтобы остальной курс не знал, откуда взялись кропы.
Файлы урока
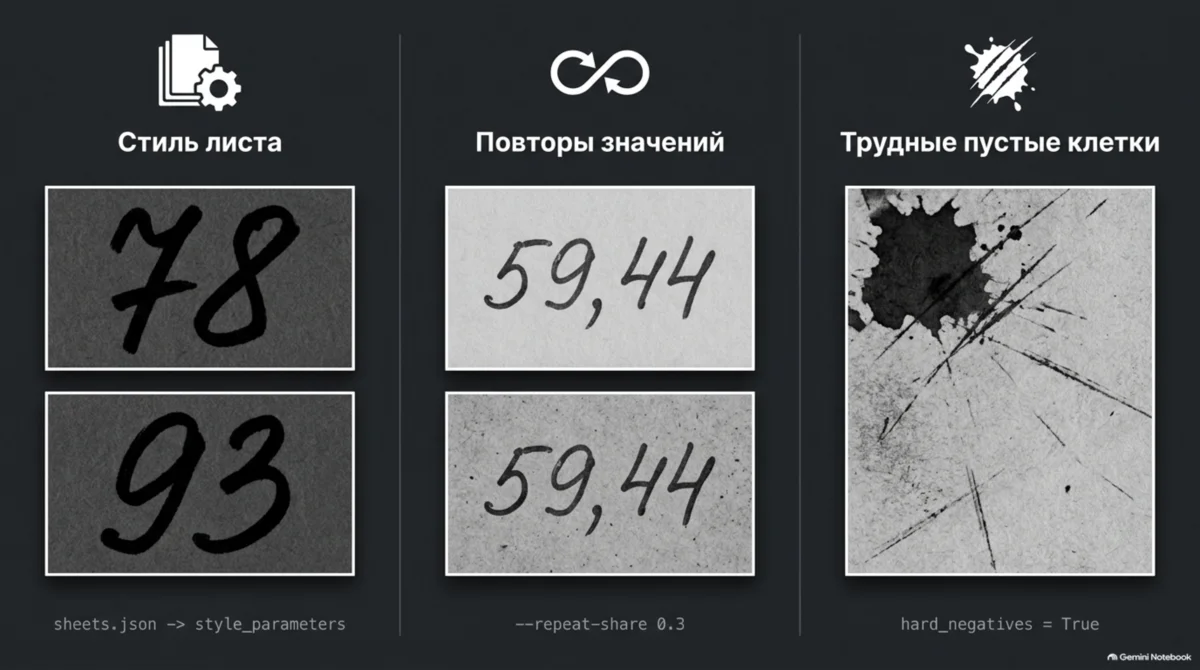
src/make_synthetic_crops.py— генератор: листы со своим стилем, повторы значений, трудные пустые клетки.src/patterns.py— класс «паттерна» метки (int,dec1,dec2,lead0, …): для статистики сейчас и для стратификации в уроке 5.src/data_sources/base.py— контракт адаптера и проверка записей.src/data_sources/synthetic.py— первая реализация адаптера (читает папку генератора).src/data_sources/__init__.py— делает папку пакетом.src/prepare_dataset.py— источник →all.jsonl+manifest.json.experiments/show_samples_grid.py— сетка образцов из разных листов.tests/test_data_source_contract.pyиtests/test_synthetic_generator.py— тесты.
Эталон для сверки, если генерация не сошлась: lesson-04. Клонировать его не нужно: файлы урока вы дописываете в свой репозиторий и коммитите.
Предскажи
Раздел «Предскажи» — не оценка. Вы фиксируете ожидание до запуска, потом сверяете с манифестом и отчётом контракта.
Перед запуском запишите ответы:
- Сколько кропов получится при
--sheets 250 --per-sheet 20и какую долю составят пустые? - При
--repeat-share 0.3какая доля value-кропов будет повторять значение, уже встречавшееся на том же листе: меньше 30 %, около 30 % или больше? - Что должно произойти, если источник отдаст кроп с меткой
7.3(с точкой)?
Как устроен генератор
Генератор — самый длинный файл курса (около 280 строк). Шесть идей ниже задают устройство; полный код — в свёрнутом блоке раздела «Напиши сам». Если команды не дают вывод из блока «Ожидаемое», сверьте файлы с эталоном lesson-04 в браузере.
1. Лист = стиль. Каждый лист получает свой набор параметров (они пишутся в sheets.json), и все кропы листа рисуются в этом стиле.
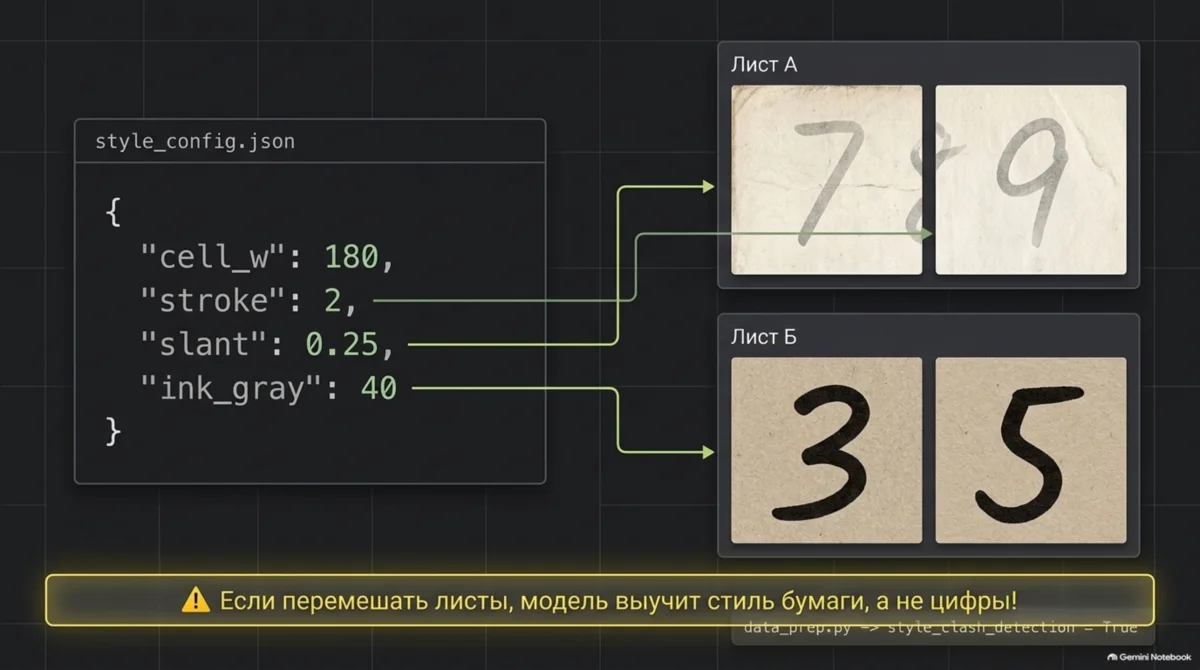
| Параметр | Что меняет |
|---|---|
cell_w, cell_h |
размер клетки (≈ 110–200 × 40–64 px) |
font_ratio |
размер цифр относительно высоты клетки |
stroke |
толщина пера (0, 1 или 2 px обводки) |
slant |
наклон всей строки |
jitter_dy, jitter_rot |
насколько «пляшут» отдельные символы по вертикали и по углу |
ink_gray, paper_gray |
цвет чернил и бумаги |
paper_noise, shade, blur |
шум бумаги, перепад освещения, размытие |
border, border_gray |
есть ли линия-рамка клетки |
Зачем это нужно: в реальных сканах кропы одного листа похожи друг на друга (одно перо, одна бумага, один сканер). Если сплит перемешает листы, модель выучит стиль листа, а не цифры. В уроке 5 мы это увидим своими глазами.
2. Символы рисуются по одному. Каждый символ получает свой небольшой сдвиг и поворот, потом вся строка наклоняется. Так цифры выглядят «от руки», а не как набранный шрифт. Внутри мы пользуемся единственным встроенным шрифтом Pillow, а разнообразие даёт геометрия и перо.
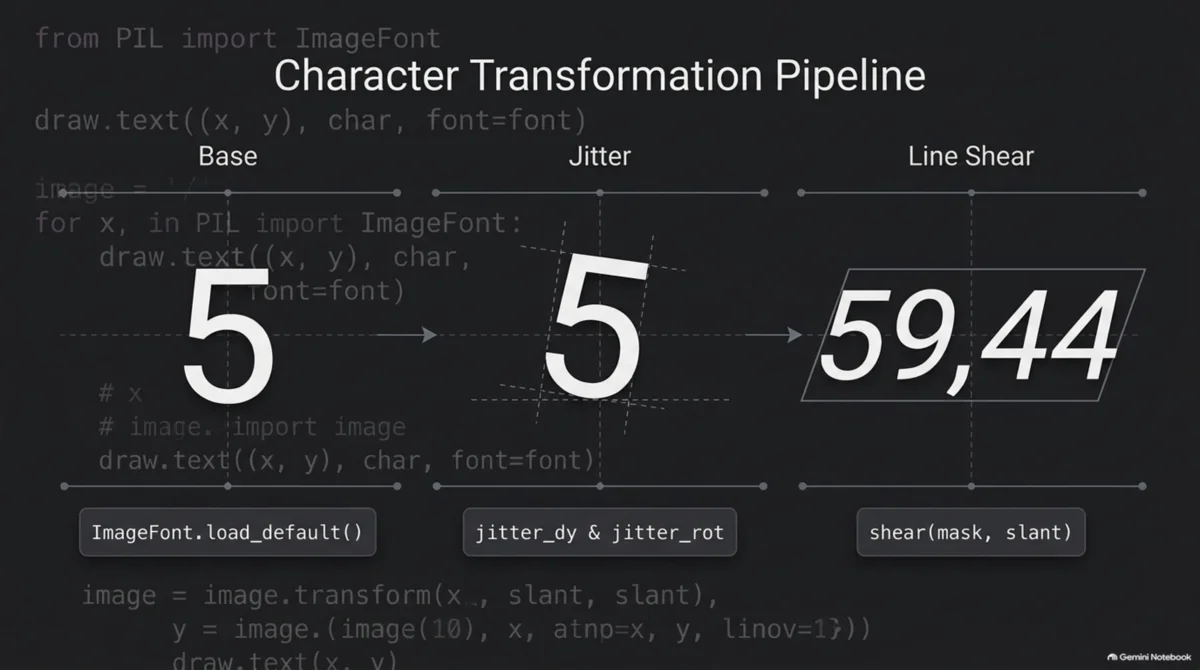
3. Значения повторяются внутри листа. С вероятностью --repeat-share (по умолчанию 0.3) кроп повторяет значение, которое на этом листе уже встречалось. В реальных бланках так и бывает. Именно это делает утечку из урока 5 заметной: если соседние клетки одного листа окажутся и в train, и в val, модель просто вспомнит ответ.
4. Пустые клетки бывают трудными. Чистая бумага — это лёгкий случай. Реальные пустые клетки зачёркнуты, подчёркнуты, запачканы или поцарапаны. Генератор делает шесть видов:
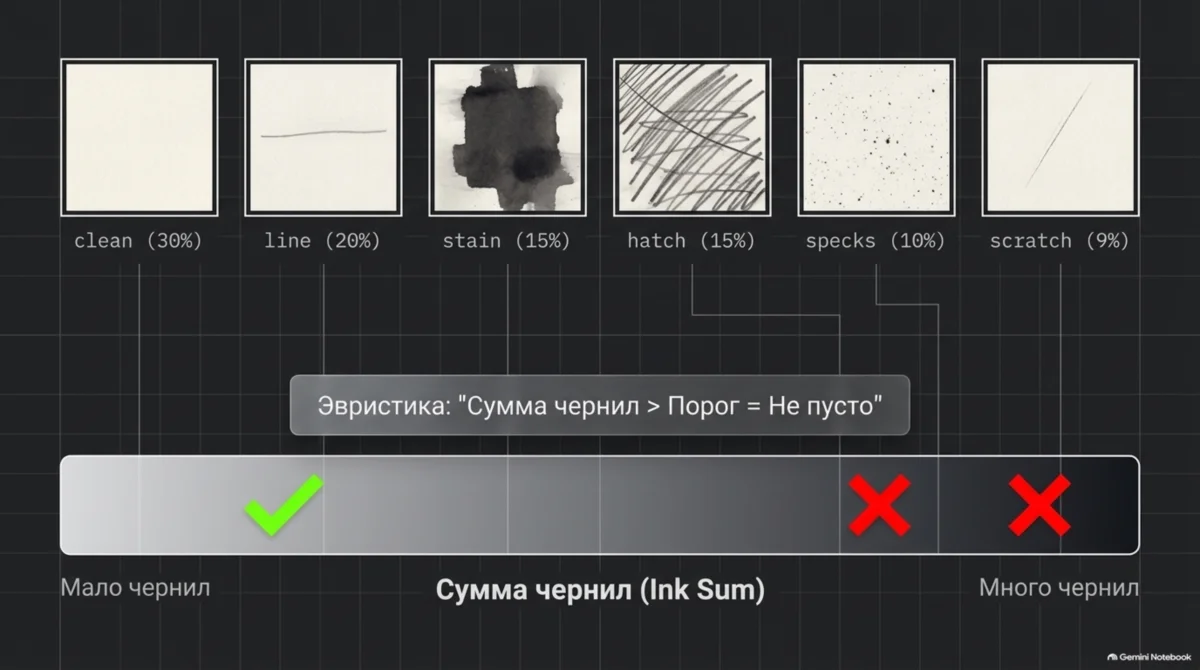
| Вид | Что нарисовано | Доля среди пустых |
|---|---|---|
clean |
только бумага и шум | ≈ 30 % |
line |
подчёркивание или вертикальная черта | ≈ 20 % |
stain |
размытое пятно | ≈ 15 % |
hatch |
штриховка (клетка зачёркнута) | ≈ 15 % |
specks |
точки | ≈ 10 % |
scratch |
царапина | ≈ 9 % |
Представьте наивное правило без нейросети: посчитать, сколько на кропе «тёмного» (чернил), и если мало — клетка пустая, если много — там цифры. На чистой бумаге это почти всегда срабатывает. Но зачёркнутая или запачканная пустая клетка тоже даёт много чернил — правило решит, что там значение, хотя цифр нет. Такие примеры называют трудными отрицательными (hard negatives): они похожи на заполненные по количеству штрихов, но метка у них «пусто». Без них детектор из уроков 7–9 учился бы отличать белый квадрат от цифр и на реальных бланках ошибался бы на грязи.
5. Каждый лист живёт в своём потоке случайности. Лист с номером s рисуется генератором default_rng([seed, s]). Поэтому лист №3 получится одинаковым и при --sheets 5, и при --sheets 250. Это проверяет тест test_sheets_are_independent_of_total_count.
6. Шум бумаги слабый намеренно. В уроке 2 мы поставили защиту: если диапазон яркости кропа меньше 30 уровней, контраст не растягивается. Эта защита грубая: она держится, пока шум слабый. Поэтому у нас paper_noise от 1 до 3. Тест test_clean_empty_crops_are_left_alone_by_contrast_guard связывает урок 4 с уроком 2 и сразу покраснеет, если вы увеличите шум.
Дополнительно у генератора есть флаг --task: measurement (по умолчанию), diameter или thickness. Сегодня используем первый. Остальные пригодятся в уроке 16.
Адаптеры источников данных
Контракт. Любой источник отдаёт записи одного вида:
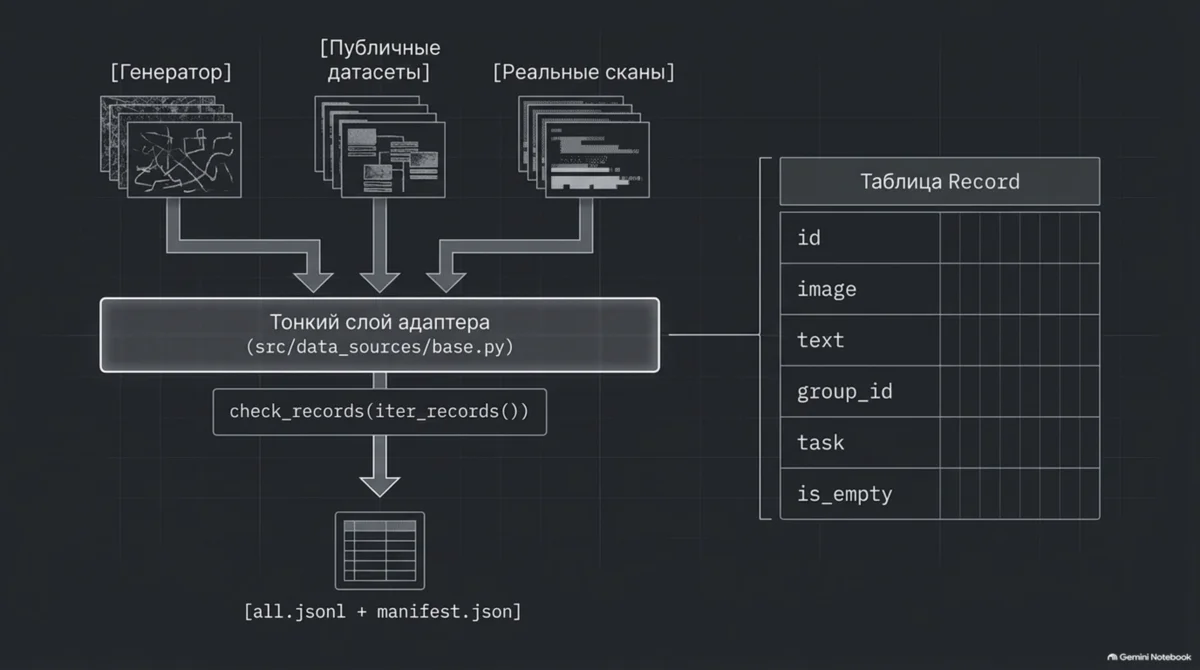
| Поле | Смысл |
|---|---|
id |
уникальный идентификатор кропа |
image |
путь к картинке относительно image_root |
text |
нормализованная метка; '' для пустой клетки |
group_id |
единица сплита (лист, виртуальный лист, официальный сплит источника) |
task |
measurement, diameter или thickness |
is_empty |
true для пустой клетки |
Плюс словарь meta(): source, task, alphabet, license, image_root. Лицензия попадёт в манифест: когда появятся публичные данные, это будет важно.
Путь image хранится относительно папки image_root (она записана в манифесте). Так датасет можно перенести на другой компьютер, не переписывая all.jsonl.
src/data_sources/base.py
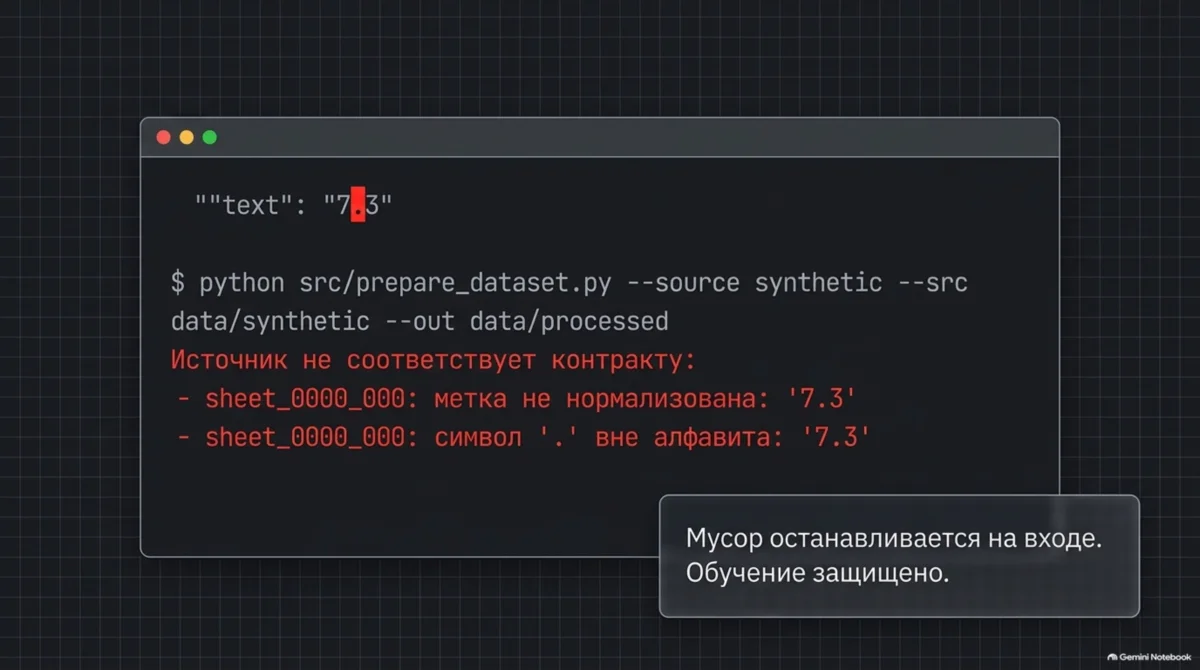
Самое ценное здесь — check_records. Она применяет к каждой записи всё, чему мы научились в уроке 3: метка должна быть нормализованной, проходить проверку алфавита и формата, а пустая метка должна совпадать с is_empty. Мусор останавливается на входе и не доходит до обучения. Полный файл — в «Напиши сам».
src/data_sources/synthetic.py
Адаптер почти ничего не делает: переименовывает поля родного формата генератора (sheet → group_id, kind → is_empty) и собирает meta(). Так и должен выглядеть хороший адаптер: тонкий.
src/prepare_dataset.py
Скрипт выбирает адаптер по --source, проверяет контракт (при нарушении печатает список и завершается с кодом 1), сортирует записи и пишет all.jsonl и manifest.json. Манифест без дат и временных меток: один и тот же вход всегда даёт один и тот же манифест. Источники public и real пока сообщают, что подключатся позже (приложения A2 и A4).
Напиши сам
Сначала положите файлы в репозиторий из урока 1. Блоки ниже свёрнуты — разверните и скопируйте в указанные пути. Шесть идей генератора — в разделе выше; длинный код набираете из блоков, а не с экрана терминала.
Генератор вызывает validate_format из урока 3. Если в src/alphabet.py ещё стоят NotImplementedError (заготовка с TODO), сначала допишите алфавит или скопируйте решение из свёрнутого блока урока 3 — иначе make_synthetic_crops.py упадёт на первой же метке. Быстрая проверка: python -m pytest tests/test_alphabet.py -q → 12 passed.
Запуск команд урока 4 — после того как файлы на месте и алфавит зелёный.
src/make_synthetic_crops.py — генератор (~280 строк) (развернуть)
"""Генератор синтетических кропов.
Что моделируем (это то, на чём потом ловятся ошибки):
* у каждого листа свой стиль: размер клетки, толщина пера, наклон, шум, фон;
* значения внутри листа повторяются (как в реальных бланках);
* пустые клетки бывают трудными: пятна, линии, штриховка, царапины.
Результат в папке --out:
images/<sheet_id>/<n>.png кропы
index.jsonl одна строка на кроп (родной формат генератора)
sheets.json стиль каждого листа
generator.json параметры запуска и версия генератора
"""
import argparse
import json
import math
from pathlib import Path
import numpy as np
from PIL import Image, ImageChops, ImageDraw, ImageFilter, ImageFont
from alphabet import normalize_label, validate_format
GENERATOR_VERSION = "1"
MEASUREMENT_KINDS = {"dec1": 0.50, "dec2": 0.25, "int": 0.20, "lead0": 0.05}
DIAMETER_KINDS = {"single": 0.60, "fraction": 0.40}
THICKNESS_KINDS = {"single": 0.45, "range": 0.55}
EMPTY_KINDS = {"clean": 0.30, "stain": 0.15, "line": 0.20, "hatch": 0.15, "scratch": 0.10, "specks": 0.10}
TASKS = ("measurement", "diameter", "thickness")
# ----------------------------------------------------------------------------- значения
def choice_weighted(rng: np.random.Generator, weights: dict):
keys = list(weights)
p = np.array([weights[k] for k in keys], dtype=float)
return keys[int(rng.choice(len(keys), p=p / p.sum()))]
def rand_int_part(rng: np.random.Generator) -> int:
n_digits = choice_weighted(rng, {1: 0.45, 2: 0.40, 3: 0.15})
lo = 1 if n_digits == 1 else 10 ** (n_digits - 1)
return int(rng.integers(lo, 10 ** n_digits))
def rand_number(rng: np.random.Generator) -> str:
"""Число для thickness: 1–2 цифры, иногда с десятичной запятой."""
base = int(rng.integers(1, 31))
return f"{base},{int(rng.integers(1, 10))}" if rng.random() < 0.5 else str(base)
def make_value(task: str, rng: np.random.Generator) -> str:
if task == "measurement":
kind = choice_weighted(rng, MEASUREMENT_KINDS)
if kind == "int":
return str(rand_int_part(rng))
if kind == "dec1":
return f"{rand_int_part(rng)},{int(rng.integers(0, 10))}"
if kind == "dec2":
return f"{rand_int_part(rng)},{int(rng.integers(0, 100)):02d}"
if rng.random() < 0.5:
return f"0,{int(rng.integers(1, 10))}"
return f"0,{int(rng.integers(1, 100)):02d}"
if task == "diameter":
if choice_weighted(rng, DIAMETER_KINDS) == "single":
return str(int(rng.integers(10, 1000)))
return f"{int(rng.integers(10, 100))}/{int(rng.integers(10, 100))}"
if task == "thickness":
if choice_weighted(rng, THICKNESS_KINDS) == "single":
return rand_number(rng)
return f"{rand_number(rng)}-{rand_number(rng)}"
raise ValueError(f"неизвестная задача {task!r}")
# ----------------------------------------------------------------------------- стиль листа
def sample_style(rng: np.random.Generator) -> dict:
return {
"cell_w": int(rng.integers(110, 201)),
"cell_h": int(rng.integers(40, 65)),
"font_ratio": round(float(rng.uniform(0.50, 0.70)), 3),
"stroke": int(rng.choice([0, 0, 1, 1, 2])),
"slant": round(float(rng.uniform(-0.25, 0.25)), 3),
"jitter_dy": round(float(rng.uniform(0.0, 1.8)), 2),
"jitter_rot": round(float(rng.uniform(0.0, 5.0)), 2),
"ink_gray": int(rng.integers(10, 91)),
"paper_gray": int(rng.integers(215, 253)),
"paper_noise": round(float(rng.uniform(1.0, 3.0)), 2),
"shade": round(float(rng.uniform(0.0, 5.0)), 2),
"blur": float(rng.choice([0.0, 0.5, 0.8])),
"left_pad": int(rng.integers(5, 15)),
"border": bool(rng.random() < 0.5),
"border_gray": int(rng.integers(120, 190)),
}
# ----------------------------------------------------------------------------- отрисовка
def get_font(size: int):
try:
return ImageFont.load_default(size=size)
except Exception: # старый Pillow или нет FreeType
return ImageFont.load_default()
def paste_lighter(dst: Image.Image, src: Image.Image, x: int, y: int) -> None:
"""Накладывает src на dst (берём более яркий пиксель), с обрезкой по границам."""
w, h = dst.size
sx0, sy0 = max(0, -x), max(0, -y)
dx0, dy0 = max(0, x), max(0, y)
cw = min(src.width - sx0, w - dx0)
ch = min(src.height - sy0, h - dy0)
if cw <= 0 or ch <= 0:
return
region = dst.crop((dx0, dy0, dx0 + cw, dy0 + ch))
patch = src.crop((sx0, sy0, sx0 + cw, sy0 + ch))
dst.paste(ImageChops.lighter(region, patch), (dx0, dy0))
def draw_text_mask(mask: Image.Image, text: str, style: dict, rng: np.random.Generator) -> None:
"""Рисует текст посимвольно (у каждого символа свой сдвиг и поворот) на маске чернил."""
w, h = mask.size
stroke = style["stroke"]
size = max(10, round(style["font_ratio"] * h))
pad = style["left_pad"] + int(rng.integers(-2, 3))
while True:
font = get_font(size)
advances = [font.getlength(ch) + 1 + stroke for ch in text]
if sum(advances) <= w - pad - 4 or size <= 10:
break
size -= 2
bbox = font.getbbox("0")
y0 = (h - (bbox[3] - bbox[1])) // 2 - bbox[1]
x = float(pad)
for ch, adv in zip(text, advances):
dy = float(rng.normal(0.0, style["jitter_dy"]))
rot = float(rng.normal(0.0, style["jitter_rot"]))
tile = Image.new("L", (int(adv) + size, size * 2), 0)
ImageDraw.Draw(tile).text((size // 2, size // 2), ch, font=font, fill=255,
stroke_width=stroke, stroke_fill=255)
if abs(rot) > 0.01:
tile = tile.rotate(rot, resample=Image.Resampling.BICUBIC)
paste_lighter(mask, tile, int(round(x)) - size // 2, int(round(y0 + dy)) - size // 2)
x += adv
def shear(mask: Image.Image, slant: float) -> Image.Image:
if abs(slant) < 1e-3:
return mask
w, h = mask.size
return mask.transform((w, h), Image.Transform.AFFINE, (1, slant, -slant * h / 2, 0, 1, 0),
resample=Image.Resampling.BICUBIC)
def draw_empty_marks(mask: Image.Image, kind: str, rng: np.random.Generator) -> None:
"""Трудные пустые клетки: пятна, линии, штриховка, царапины, точки (kind='clean' — ничего)."""
w, h = mask.size
draw = ImageDraw.Draw(mask)
if kind == "stain":
layer = Image.new("L", (w, h), 0)
ld = ImageDraw.Draw(layer)
for _ in range(int(rng.integers(1, 4))):
cx, cy = int(rng.integers(0, w)), int(rng.integers(0, h))
rx, ry = int(rng.integers(6, 22)), int(rng.integers(4, 14))
ld.ellipse([cx - rx, cy - ry, cx + rx, cy + ry], fill=int(rng.integers(50, 130)))
layer = layer.filter(ImageFilter.GaussianBlur(float(rng.uniform(2.5, 5.0))))
paste_lighter(mask, layer, 0, 0)
elif kind == "line":
y = int(rng.integers(h // 2, h - 3))
x1 = int(rng.integers(0, w // 3))
x2 = int(rng.integers(2 * w // 3, w))
draw.line([(x1, y), (x2, y)], fill=int(rng.integers(140, 230)), width=int(rng.integers(1, 3)))
if rng.random() < 0.3:
xv = int(rng.integers(0, w))
draw.line([(xv, 0), (xv, h)], fill=int(rng.integers(110, 190)), width=1)
elif kind == "hatch":
step = int(rng.integers(7, 14))
fill = int(rng.integers(120, 220))
for x in range(-h, w, step):
draw.line([(x, h), (x + h, 0)], fill=fill, width=1)
elif kind == "scratch":
for _ in range(int(rng.integers(1, 3))):
pts = [(int(rng.integers(0, w)), int(rng.integers(0, h))) for _ in range(int(rng.integers(3, 7)))]
draw.line(pts, fill=int(rng.integers(100, 200)), width=1)
elif kind == "specks":
for _ in range(int(rng.integers(3, 11))):
cx, cy = int(rng.integers(0, w)), int(rng.integers(0, h))
r = int(rng.integers(1, 3))
draw.ellipse([cx, cy, cx + r, cy + r], fill=int(rng.integers(90, 200)))
def paper_array(style: dict, rng: np.random.Generator, w: int, h: int) -> np.ndarray:
arr = rng.normal(float(style["paper_gray"]), style["paper_noise"], size=(h, w)).astype(np.float32)
angle = float(rng.uniform(0, 2 * math.pi))
xs = np.linspace(-1.0, 1.0, w, dtype=np.float32)[None, :]
ys = np.linspace(-1.0, 1.0, h, dtype=np.float32)[:, None]
return arr + style["shade"] * (math.cos(angle) * xs + math.sin(angle) * ys) / 2.0
def render_crop(text: str, empty_kind: str, style: dict, rng: np.random.Generator) -> Image.Image:
w = max(60, style["cell_w"] + int(rng.integers(-4, 5)))
h = max(30, style["cell_h"] + int(rng.integers(-3, 4)))
mask = Image.new("L", (w, h), 0)
if text:
draw_text_mask(mask, text, style, rng)
mask = shear(mask, style["slant"])
else:
draw_empty_marks(mask, empty_kind, rng)
if style["blur"] > 0:
mask = mask.filter(ImageFilter.GaussianBlur(style["blur"]))
alpha = np.asarray(mask, dtype=np.float32) / 255.0
img = paper_array(style, rng, w, h) * (1.0 - alpha) + style["ink_gray"] * alpha
if style["border"]:
img[h - 2:, :] = np.minimum(img[h - 2:, :], style["border_gray"])
return Image.fromarray(img.clip(0, 255).astype(np.uint8), mode="L")
# ----------------------------------------------------------------------------- листы
def generate(out, sheets: int, per_sheet: int, seed: int = 42, task: str = "measurement",
empty_share: float = 0.4, repeat_share: float = 0.3) -> dict:
if task not in TASKS:
raise ValueError(f"неизвестная задача {task!r}")
out = Path(out)
(out / "images").mkdir(parents=True, exist_ok=True)
styles, lines = {}, []
for s in range(sheets):
sheet_id = f"sheet_{s:04d}"
rng = np.random.default_rng([seed, s]) # у каждого листа свой независимый поток
style = sample_style(rng)
styles[sheet_id] = style
(out / "images" / sheet_id).mkdir(exist_ok=True)
values = [] # значения, уже встречавшиеся на листе
for n in range(per_sheet):
if rng.random() < empty_share:
text, kind, empty_kind = "", "empty", choice_weighted(rng, EMPTY_KINDS)
else:
if values and rng.random() < repeat_share:
text = values[int(rng.integers(0, len(values)))]
else:
text = make_value(task, rng)
values.append(text)
kind, empty_kind = "value", ""
assert normalize_label(text) == text and validate_format(text, task)[0], text
rel = f"images/{sheet_id}/{n:03d}.png"
render_crop(text, empty_kind, style, rng).save(out / rel)
lines.append({"file": rel, "text": text, "sheet": sheet_id, "task": task,
"kind": kind, "empty_kind": empty_kind})
with open(out / "index.jsonl", "w", encoding="utf-8") as f:
for rec in lines:
f.write(json.dumps(rec, ensure_ascii=False) + "\n")
(out / "sheets.json").write_text(json.dumps(styles, indent=1, ensure_ascii=False), encoding="utf-8")
meta = {"version": GENERATOR_VERSION, "seed": seed, "task": task, "sheets": sheets,
"per_sheet": per_sheet, "empty_share": empty_share, "repeat_share": repeat_share}
(out / "generator.json").write_text(json.dumps(meta, indent=1), encoding="utf-8")
return meta
def main() -> None:
ap = argparse.ArgumentParser(description=__doc__, formatter_class=argparse.RawDescriptionHelpFormatter)
ap.add_argument("--out", default="data/synthetic")
ap.add_argument("--sheets", type=int, default=250)
ap.add_argument("--per-sheet", type=int, default=20)
ap.add_argument("--seed", type=int, default=42)
ap.add_argument("--task", choices=TASKS, default="measurement")
ap.add_argument("--empty-share", type=float, default=0.4)
ap.add_argument("--repeat-share", type=float, default=0.3)
args = ap.parse_args()
meta = generate(args.out, args.sheets, args.per_sheet, args.seed, args.task,
args.empty_share, args.repeat_share)
print(f"готово: {args.sheets} листов × {args.per_sheet} кропов = {args.sheets * args.per_sheet} "
f"в {args.out} (task={meta['task']}, seed={meta['seed']})")
if __name__ == "__main__":
main()src/patterns.py — паттерны меток (развернуть)
"""Класс «паттерна» метки: нужен для статистики датасета и (в уроке 5) для стратификации листов."""
def label_pattern(text: str, task: str) -> str:
if text == "":
return "empty"
if task == "measurement":
if text.startswith("0,"):
return "lead0"
if "," not in text:
return "int"
return "dec1" if len(text.split(",")[1]) == 1 else "dec2"
if task == "diameter":
return "fraction" if "/" in text else "single"
if task == "thickness":
return "range" if "-" in text else "single"
raise ValueError(f"неизвестная задача {task!r}")src/data_sources/__init__.py — пакет адаптеров (развернуть)
"""Адаптеры источников данных (контракт — в base.py)."""src/data_sources/base.py — контракт Record и check_records (развернуть)
"""Контракт адаптера источника данных.
Любой источник (синтетика, публичные датасеты, реальные листы) приводится к одной схеме.
Остальной курс читает только all.jsonl и split.json и про источник ничего не знает.
"""
from abc import ABC, abstractmethod
from pathlib import Path
from typing import Iterator, TypedDict
from alphabet import normalize_label, validate_format
REQUIRED_META = ("source", "task", "alphabet", "license", "image_root")
class Record(TypedDict):
id: str # уникальный идентификатор кропа
image: str # путь к картинке относительно image_root
text: str # нормализованная метка; '' для пустой клетки
group_id: str # единица сплита (лист, виртуальный лист, официальный сплит)
task: str # measurement | diameter | thickness
is_empty: bool
class DataSource(ABC):
@abstractmethod
def iter_records(self) -> Iterator[Record]:
"""Отдаёт записи схемы Record."""
@abstractmethod
def meta(self) -> dict:
"""Словарь с ключами REQUIRED_META (+ любые дополнительные сведения об источнике)."""
def check_meta(meta: dict) -> list[str]:
return [f"meta: нет ключа {k!r}" for k in REQUIRED_META if k not in meta]
def check_records(records, image_root, task: str, max_errors: int = 20) -> list[str]:
"""Проверяет записи на соответствие контракту. Возвращает список ошибок (пустой = всё хорошо)."""
image_root = Path(image_root)
errors: list[str] = []
seen: set[str] = set()
total_errors = 0
def add(msg: str) -> None:
nonlocal total_errors
total_errors += 1
if len(errors) < max_errors:
errors.append(msg)
for rec in records:
rid = rec.get("id", "<без id>")
missing = [k for k in ("id", "image", "text", "group_id", "task", "is_empty") if k not in rec]
if missing:
add(f"{rid}: нет полей {missing}")
continue
if rec["id"] in seen:
add(f"{rid}: повторяющийся id")
seen.add(rec["id"])
if not rec["group_id"]:
add(f"{rid}: пустой group_id")
if rec["task"] != task:
add(f"{rid}: task={rec['task']!r}, ожидалось {task!r}")
if not isinstance(rec["is_empty"], bool):
add(f"{rid}: is_empty должно быть bool")
if rec["is_empty"] != (rec["text"] == ""):
add(f"{rid}: is_empty не согласовано с text={rec['text']!r}")
if rec["text"] != normalize_label(rec["text"]):
add(f"{rid}: метка не нормализована: {rec['text']!r}")
ok, reason = validate_format(rec["text"], rec["task"])
if not ok:
add(f"{rid}: {reason}: {rec['text']!r}")
if not (image_root / rec["image"]).is_file():
add(f"{rid}: нет файла {image_root / rec['image']}")
if total_errors > len(errors):
errors.append(f"... и ещё {total_errors - len(errors)} ошибок")
return errorssrc/data_sources/synthetic.py — адаптер синтетики (развернуть)
"""Адаптер синтетического источника: читает папку, созданную make_synthetic_crops.py."""
import json
from pathlib import Path
from typing import Iterator
from alphabet import get_alphabet
from data_sources.base import DataSource, Record
class SyntheticSource(DataSource):
def __init__(self, root) -> None:
self.root = Path(root)
def iter_records(self) -> Iterator[Record]:
counters: dict[str, int] = {}
with open(self.root / "index.jsonl", encoding="utf-8") as f:
for line in f:
raw = json.loads(line)
n = counters.get(raw["sheet"], 0)
counters[raw["sheet"]] = n + 1
yield Record(
id=f"{raw['sheet']}_{n:03d}",
image=raw["file"],
text=raw["text"],
group_id=raw["sheet"],
task=raw["task"],
is_empty=raw["kind"] == "empty",
)
def meta(self) -> dict:
gen = json.loads((self.root / "generator.json").read_text(encoding="utf-8"))
return {
"source": "synthetic",
"task": gen["task"],
"alphabet": get_alphabet(gen["task"]),
"license": "сгенерировано этим репозиторием, ограничений нет",
"image_root": str(self.root),
"generator": gen,
}src/prepare_dataset.py — источник → all.jsonl (развернуть)
"""Источник данных → data/processed/all.jsonl + manifest.json (единая схема для всех уроков)."""
import argparse
import json
import sys
from collections import Counter, defaultdict
from collections.abc import Sequence
from pathlib import Path
from alphabet import num_classes
from data_sources.base import Record, check_meta, check_records
from data_sources.synthetic import SyntheticSource
from patterns import label_pattern
SCHEMA = ["id", "image", "text", "group_id", "task", "is_empty"]
def build_source(name: str, src: str):
if name == "synthetic":
if not (Path(src) / "index.jsonl").is_file():
sys.exit(f"В {src} нет index.jsonl. Сначала: python src/make_synthetic_crops.py --out {src}")
return SyntheticSource(src)
sys.exit(f"Источник {name!r} подключается позже: public — приложение A2, real — приложение A4.")
def repeat_share(records: Sequence[Record]) -> float:
"""Доля value-кропов, чьё значение встречается на том же листе ещё раз."""
by_group = defaultdict(Counter)
for r in records:
if not r["is_empty"]:
by_group[r["group_id"]][r["text"]] += 1
value_total = sum(sum(c.values()) for c in by_group.values())
repeated = sum(n for c in by_group.values() for n in c.values() if n > 1)
return repeated / value_total if value_total else 0.0
def main() -> None:
ap = argparse.ArgumentParser()
ap.add_argument("--source", choices=["synthetic", "public", "real"], required=True)
ap.add_argument("--src", required=True, help="папка источника")
ap.add_argument("--out", default="data/processed")
args = ap.parse_args()
source = build_source(args.source, args.src)
meta = source.meta()
problems = check_meta(meta)
records = sorted(source.iter_records(), key=lambda r: (r["group_id"], r["id"]))
problems += check_records(records, meta["image_root"], meta["task"])
if problems:
print("Источник не соответствует контракту:")
for p in problems:
print(" -", p)
sys.exit(1)
out = Path(args.out)
out.mkdir(parents=True, exist_ok=True)
with open(out / "all.jsonl", "w", encoding="utf-8") as f:
for r in records:
f.write(json.dumps({k: r[k] for k in SCHEMA}, ensure_ascii=False) + "\n")
per_group = Counter(r["group_id"] for r in records)
empty = sum(r["is_empty"] for r in records)
manifest = {
"schema_version": 1,
"source": meta["source"],
"task": meta["task"],
"alphabet": meta["alphabet"],
"num_classes": num_classes(meta["task"]),
"image_root": meta["image_root"],
"license": meta["license"],
"fields": SCHEMA,
"counts": {"total": len(records), "value": len(records) - empty, "empty": empty},
"empty_share": round(empty / len(records), 4),
"groups": len(per_group),
"crops_per_group": {"min": min(per_group.values()), "max": max(per_group.values())},
"patterns": dict(sorted(Counter(label_pattern(r["text"], r["task"]) for r in records).items())),
"repeated_on_sheet_share": round(repeat_share(records), 4),
"generator": meta.get("generator"),
}
(out / "manifest.json").write_text(json.dumps(manifest, indent=2, ensure_ascii=False), encoding="utf-8")
print(f"записано {len(records)} кропов ({manifest['counts']['value']} value, {empty} empty), "
f"{len(per_group)} групп -> {out / 'all.jsonl'}")
print(f"манифест: {out / 'manifest.json'}")
if __name__ == "__main__":
main()experiments/show_samples_grid.py — сетка образцов (развернуть)
"""Сетка образцов: 8 value и 8 empty из разных листов (видно, как различаются стили листов)."""
import argparse
import json
import random
import sys
from pathlib import Path
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt # noqa: E402
from PIL import Image # noqa: E402
def pick(records: list[dict], n: int, rng: random.Random) -> list[dict]:
"""По одному кропу с n разных листов."""
by_group: dict[str, list[dict]] = {}
for r in records:
by_group.setdefault(r["group_id"], []).append(r)
groups = rng.sample(sorted(by_group), min(n, len(by_group)))
return [rng.choice(by_group[g]) for g in groups]
def main() -> None:
ap = argparse.ArgumentParser()
ap.add_argument("--data-dir", default="data/processed")
ap.add_argument("--out", default="experiments/samples_grid.png")
ap.add_argument("--seed", type=int, default=0)
args = ap.parse_args()
data_dir = Path(args.data_dir)
manifest = json.loads((data_dir / "manifest.json").read_text(encoding="utf-8"))
records = [json.loads(line) for line in open(data_dir / "all.jsonl", encoding="utf-8")]
rng = random.Random(args.seed)
values = pick([r for r in records if not r["is_empty"]], 8, rng)
empties = pick([r for r in records if r["is_empty"]], 8, rng)
if len(values) < 8 or len(empties) < 8:
sys.exit("Мало листов для сетки 8 + 8: сгенерируйте больше листов.")
fig, axes = plt.subplots(4, 4, figsize=(11, 6.5))
for ax, rec, kind in zip(axes.flat, values + empties, ["value"] * 8 + ["empty"] * 8):
ax.imshow(Image.open(Path(manifest["image_root"]) / rec["image"]), cmap="gray", vmin=0, vmax=255)
label = rec["text"] if kind == "value" else "(пусто)"
ax.set_title(f"{label} {rec['group_id']}", fontsize=8)
ax.set_xticks([])
ax.set_yticks([])
fig.suptitle("Верхние два ряда: value; нижние два: empty (включая трудные). Каждый кроп с другого листа.",
fontsize=9)
fig.tight_layout()
out = Path(args.out)
out.parent.mkdir(parents=True, exist_ok=True)
fig.savefig(out, dpi=110)
print(f"сохранено: {out}")
if __name__ == "__main__":
main()tests/test_data_source_contract.py — тесты контракта (развернуть)
import sys
import tempfile
from pathlib import Path
from PIL import Image
sys.path.insert(0, str(Path(__file__).resolve().parents[1] / "src"))
from data_sources.base import REQUIRED_META, check_meta, check_records # noqa: E402
from data_sources.synthetic import SyntheticSource # noqa: E402
from make_synthetic_crops import generate # noqa: E402
def assert_contract(source) -> None:
"""Контракт-тест: его должен проходить ЛЮБОЙ адаптер (synthetic, public, real)."""
meta = source.meta()
assert check_meta(meta) == [], check_meta(meta)
records = list(source.iter_records())
assert records, "источник не отдал ни одной записи"
errors = check_records(records, meta["image_root"], meta["task"])
assert errors == [], errors
assert any(r["is_empty"] for r in records) and any(not r["is_empty"] for r in records)
def test_synthetic_source_passes_contract():
with tempfile.TemporaryDirectory() as d:
generate(d, sheets=4, per_sheet=10, seed=1)
assert_contract(SyntheticSource(d))
def test_meta_has_required_keys():
with tempfile.TemporaryDirectory() as d:
generate(d, sheets=1, per_sheet=2, seed=1)
meta = SyntheticSource(d).meta()
for key in REQUIRED_META:
assert key in meta
# --- контракт должен ловить типовые нарушения --------------------------------
def make_record(image: str, **over) -> dict:
rec = {"id": "g1_000", "image": image, "text": "7,3", "group_id": "g1",
"task": "measurement", "is_empty": False}
rec.update(over)
return rec
def with_png(fn):
with tempfile.TemporaryDirectory() as d:
Image.new("L", (10, 10), 255).save(Path(d) / "a.png")
fn(d)
def test_check_records_accepts_good_record():
def run(d):
assert check_records([make_record("a.png")], d, "measurement") == []
with_png(run)
def test_check_records_catches_violations():
def run(d):
cases = {
"нет файла": make_record("missing.png"),
"пустой group_id": make_record("a.png", group_id=""),
"не нормализована": make_record("a.png", text="7.3"),
"is_empty не согласовано": make_record("a.png", text="", is_empty=False),
"формат": make_record("a.png", text="01,02,24"),
"чужая задача": make_record("a.png", task="diameter"),
}
for name, rec in cases.items():
assert check_records([rec], d, "measurement"), f"нарушение не поймано: {name}"
dup = [make_record("a.png"), make_record("a.png")]
assert check_records(dup, d, "measurement"), "повторяющийся id не пойман"
with_png(run)tests/test_synthetic_generator.py — тесты генератора (развернуть)
import atexit
import json
import sys
import tempfile
from pathlib import Path
sys.path.insert(0, str(Path(__file__).resolve().parents[1] / "src"))
from alphabet import validate_format # noqa: E402
from image_to_tensor import MIN_CONTRAST_RANGE # noqa: E402
from make_synthetic_crops import EMPTY_KINDS, generate # noqa: E402
from patterns import label_pattern # noqa: E402
from PIL import Image # noqa: E402
_cache: dict = {}
_tmp: list = []
def read_index(root):
with open(Path(root) / "index.jsonl", encoding="utf-8") as f:
return [json.loads(line) for line in f]
def big_dataset() -> Path:
"""60 листов × 20 кропов, seed 42; создаётся один раз на все тесты."""
if "big" not in _cache:
d = tempfile.TemporaryDirectory()
_tmp.append(d)
generate(d.name, sheets=60, per_sheet=20, seed=42)
_cache["big"] = Path(d.name)
return _cache["big"]
atexit.register(lambda: [d.cleanup() for d in _tmp])
def test_same_seed_gives_identical_files():
with tempfile.TemporaryDirectory() as a, tempfile.TemporaryDirectory() as b:
generate(a, sheets=3, per_sheet=8, seed=7)
generate(b, sheets=3, per_sheet=8, seed=7)
assert (Path(a) / "index.jsonl").read_bytes() == (Path(b) / "index.jsonl").read_bytes()
for rec in read_index(a):
assert (Path(a) / rec["file"]).read_bytes() == (Path(b) / rec["file"]).read_bytes()
def test_sheets_are_independent_of_total_count():
# Листы строятся независимыми потоками: первые 3 листа не зависят от того, сколько листов всего.
with tempfile.TemporaryDirectory() as a, tempfile.TemporaryDirectory() as b:
generate(a, sheets=3, per_sheet=8, seed=7)
generate(b, sheets=6, per_sheet=8, seed=7)
first_a = read_index(a)
first_b = [r for r in read_index(b) if r["sheet"] in {r2["sheet"] for r2 in first_a}]
assert first_a == first_b
for rec in first_a:
assert (Path(a) / rec["file"]).read_bytes() == (Path(b) / rec["file"]).read_bytes()
def test_labels_valid_for_all_tasks_and_patterns_present():
expected = {"measurement": {"dec1", "dec2", "int", "lead0"},
"diameter": {"single", "fraction"},
"thickness": {"single", "range"}}
for task, patterns in expected.items():
with tempfile.TemporaryDirectory() as d:
generate(d, sheets=10, per_sheet=20, seed=3, task=task)
texts = [r["text"] for r in read_index(d) if r["kind"] == "value"]
for t in texts:
ok, reason = validate_format(t, task)
assert ok, f"{task}: {t!r}: {reason}"
assert {label_pattern(t, task) for t in texts} >= patterns, task
def test_empty_share_close_to_requested():
rows = read_index(big_dataset())
share = sum(r["kind"] == "empty" for r in rows) / len(rows)
assert 0.33 <= share <= 0.47, share
def test_rare_patterns_are_at_least_three_percent():
rows = read_index(big_dataset())
values = [r["text"] for r in rows if r["kind"] == "value"]
for pattern in ("dec1", "dec2", "int", "lead0"):
share = sum(label_pattern(t, "measurement") == pattern for t in values) / len(values)
assert share >= 0.03, f"{pattern}: {share:.3f}"
def test_all_hard_negative_kinds_occur():
rows = read_index(big_dataset())
kinds = {r["empty_kind"] for r in rows if r["kind"] == "empty"}
assert kinds == set(EMPTY_KINDS), kinds
def repeated_share(root) -> float:
by_sheet: dict = {}
for r in read_index(root):
if r["kind"] == "value":
by_sheet.setdefault(r["sheet"], []).append(r["text"])
total = sum(len(v) for v in by_sheet.values())
repeated = sum(1 for v in by_sheet.values() for t in v if v.count(t) > 1)
return repeated / total
def test_repeat_share_increases_repeats_on_sheet():
with tempfile.TemporaryDirectory() as a, tempfile.TemporaryDirectory() as b:
generate(a, sheets=30, per_sheet=20, seed=5, repeat_share=0.0)
generate(b, sheets=30, per_sheet=20, seed=5, repeat_share=0.6)
assert repeated_share(b) > repeated_share(a) + 0.2
def test_sheet_styles_differ():
styles = json.loads((big_dataset() / "sheets.json").read_text(encoding="utf-8"))
assert len({s["cell_w"] for s in styles.values()}) >= 20
assert len({s["ink_gray"] for s in styles.values()}) >= 20
assert {s["border"] for s in styles.values()} == {True, False}
def test_clean_empty_crops_are_left_alone_by_contrast_guard():
# Связь с уроком 2: чистая пустая клетка (без рамки) не должна растягиваться по контрасту.
root = big_dataset()
styles = json.loads((root / "sheets.json").read_text(encoding="utf-8"))
checked = 0
for r in read_index(root):
if r["kind"] == "empty" and r["empty_kind"] == "clean" and not styles[r["sheet"]]["border"]:
lo, hi = Image.open(root / r["file"]).getextrema()
assert isinstance(lo, (int, float)) and isinstance(hi, (int, float))
assert hi - lo < MIN_CONTRAST_RANGE, (r["file"], hi - lo)
checked += 1
assert checked >= 20Команды
Окружение и репозиторий из урока 1. После того как файлы урока набраны:
python src/make_synthetic_crops.py --out data/synthetic --sheets 250 --per-sheet 20 --seed 42
python src/prepare_dataset.py --source synthetic --src data/synthetic --out data/processed
python experiments/show_samples_grid.py --out experiments/samples_grid.png
python -m pytest tests/test_data_source_contract.py tests/test_synthetic_generator.py -q
Smoke
Те же команды, но маленькие и в отдельные папки:
python src/make_synthetic_crops.py --out data/synthetic-smoke --sheets 20 --per-sheet 10 --seed 42
python src/prepare_dataset.py --source synthetic --src data/synthetic-smoke --out data/processed-smoke
python experiments/show_samples_grid.py --data-dir data/processed-smoke --out experiments/samples_grid_smoke.png
python -m pytest tests/test_data_source_contract.py tests/test_synthetic_generator.py -q
Ожидаемое
Вывод первых двух команд (время генерации у вас будет своё: у меня около 15–20 секунд на 5000 кропов):
готово: 250 листов × 20 кропов = 5000 в data/synthetic (task=measurement, seed=42)
записано 5000 кропов (2968 value, 2032 empty), 250 групп -> data/processed/all.jsonl
манифест: data/processed/manifest.json
Манифест (data/processed/manifest.json):
{
  "schema_version": 1,
  "source": "synthetic",
  "task": "measurement",
  "alphabet": "0123456789,",
  "num_classes": 12,
  "image_root": "data/synthetic",
  "license": "сгенерировано этим репозиторием, ограничений нет",
  "fields": [
    "id",
    "image",
    "text",
    "group_id",
    "task",
    "is_empty"
  ],
  "counts": {
    "total": 5000,
    "value": 2968,
    "empty": 2032
  },
  "empty_share": 0.4064,
  "groups": 250,
  "crops_per_group": {
    "min": 20,
    "max": 20
  },
  "patterns": {
    "dec1": 1477,
    "dec2": 783,
    "empty": 2032,
    "int": 551,
    "lead0": 157
  },
  "repeated_on_sheet_share": 0.473,
  "generator": {
    "version": "1",
    "seed": 42,
    "task": "measurement",
    "sheets": 250,
    "per_sheet": 20,
    "empty_share": 0.4,
    "repeat_share": 0.3
  }
}
Первые строки all.jsonl:
{"id": "sheet_0000_000", "image": "images/sheet_0000/000.png", "text": "59,44", "group_id": "sheet_0000", "task": "measurement", "is_empty": false}
{"id": "sheet_0000_001", "image": "images/sheet_0000/001.png", "text": "", "group_id": "sheet_0000", "task": "measurement", "is_empty": true}
Папка data/synthetic/images занимает около 30 МБ. Тесты: 13 passed (вместе с уроками 2–3: 33 passed).
Сетка образцов (experiments/samples_grid.png). Каждый кроп взят с другого листа:
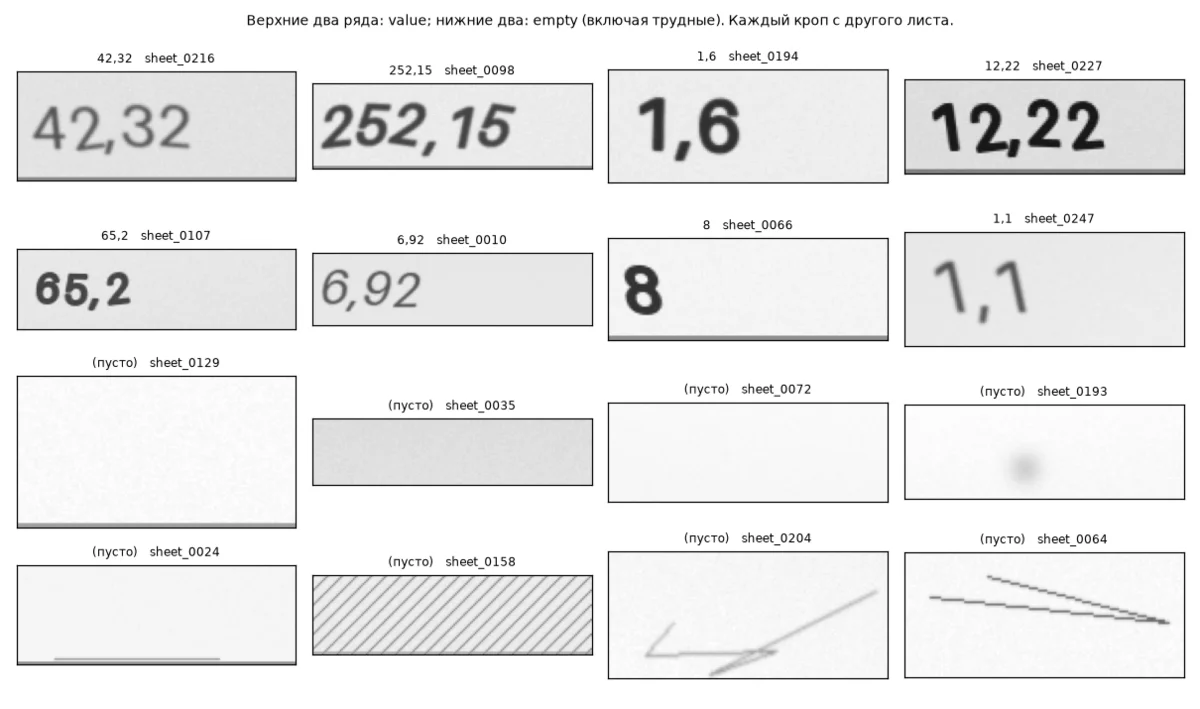
Что на ней видно: листы различаются толщиной пера, цветом чернил, наклоном, размытием и рамкой. Ряды пустых клеток содержат чистую бумагу, пятно, подчёркивание, штриховку и царапины.
Сравните с предсказаниями:
- 5000 кропов, 40.6 % пустых. Заказано 40 %, получилось чуть больше: каждый кроп пустой независимо с вероятностью 0.4.
- Повторы: 47 %, а не 30 %. Поле
repeated_on_sheet_shareсчитает долю value-кропов, чьё значение встречается на листе хотя бы дважды. А в повторе участвуют обе копии: и оригинал, и повтор. Плюс случайные совпадения коротких чисел (например,7). Так что 47 % при--repeat-share 0.3не ошибка. - Контракт сработает. Подмена одной метки на
7.3вindex.jsonlдаёт на выходеprepare_dataset.py:
Источник не соответствует контракту:
  - sheet_0000_000: метка не нормализована: '7.3'
  - sheet_0000_000: символ '.' вне алфавита: '7.3'
и код завершения 1. Файлов в data/processed в этом случае не появится.
Паттерны среди value-кропов: dec1 49.8 %, dec2 26.4 %, int 18.6 %, lead0 5.3 %. Каждый редкий паттерн заметно выше 3 %.
Упражнение (эксперимент)
- Сгенерируйте два датасета с
--repeat-share 0и--repeat-share 0.6(в разные папки) и сравнитеrepeated_on_sheet_shareв манифестах. Почему при нулевом значении параметра доля всё равно не нулевая? - Добавьте свой вид трудной пустой клетки, например «крест» из двух диагоналей. Добавьте ключ в
EMPTY_KINDSи ветку вdraw_empty_marks. Тестtest_all_hard_negative_kinds_occurсам проверит, что ваш вид встречается. - Поднимите
paper_noiseвsample_styleдо 8 и запустите тесты. Какой тест краснеет и что это говорит об уроке 2?
Если не так
NotImplementedErrorвalphabet.validate_format(илиencode_text). Это не баг генератора: вsrc/alphabet.pyосталась заготовка урока 3. Допишите TODO или возьмите решение из урока 3;pytest tests/test_alphabet.pyдолжен дать 12 passed.- «В … нет index.jsonl. Сначала: python src/make_synthetic_crops.py …». Вы запустили
prepare_dataset.pyраньше генератора или указали не ту папку в--src. - «Источник не соответствует контракту». Это не сбой, а работа проверки. Прочитайте список: он называет запись и причину.
AttributeError: ... getlengthили очень мелкий кривой текст на кропах. Старая версия Pillow. Нужна 10.1 или новее:pip install -U "Pillow>=10.1".ModuleNotFoundError: data_sourcesилиalphabet. Запускайте скрипты из корня вашего репозитория (python src/...) и убедитесь, что есть файлsrc/data_sources/__init__.py.- Генерация идёт заметно дольше минуты. На обычном ноутбуке 5000 кропов занимают порядка десятка секунд. Для отладки можно сгенерировать меньше (
--sheets 20), но для следующих уроков понадобится полный объём: размер зависит от арифметики урока 5. --source publicили--source realзавершается сообщением «подключается позже». Так и должно быть: эти адаптеры появятся в приложениях A2 и A4.
Чек-лист
- Файлы урока в вашем репозитории и закоммичены
- Сгенерирован полный набор
--sheets 250 --per-sheet 20 --seed 42 -
prepare_dataset.pyзаписалall.jsonlиmanifest.json - Сетка
samples_grid.pngсохранена - pytest урока 4 → 13 passed
- Сверены три прогноза из «Предскажи»
FAQ
Зачем group_id, если пока нет сплита?
Сплит в уроке 5 делит листы, не отдельные кропы. group_id уже сейчас фиксирует, какие кропы принадлежат одному листу — иначе утечка стиля будет незаметна в манифесте.
Почему repeated_on_sheet_share больше, чем --repeat-share?
Параметр генератора — вероятность сделать повтор при рисовании value-кропа. Манифест считает долю value-кропов, чьё значение встречается на листе ≥ 2 раза: в счёт идут и оригинал, и копии, плюс случайные совпадения коротких чисел.
Нужно ли коммитить data/synthetic?
Нет. Папка в .gitignore. Пересоздаётся командой с --seed 42; манифест при том же seed будет тем же.
Чем родной index.jsonl отличается от all.jsonl?
index.jsonl — формат генератора (sheet, file, kind, empty_kind). all.jsonl — единая схема курса через адаптер. Поле empty_kind в схему курса не попадает: детектору достаточно is_empty.
Можно ли сразу генерировать diameter?
Да: --task diameter. Сегодня курс идёт по measurement; другие задачи понадобятся в уроке 16.
Почему адаптер тонкий — почти только переименование полей?
Толстый адаптер начинает «чинить» данные молча. Мы хотим, чтобы проверка была явной в check_records, а адаптер лишь приводил имена к схеме.
Что дальше
Все 250 листов пока лежат в одном all.jsonl. Следующий урок — Урок 5. Сплит по листам и утечка. Dataset и аугментации — урок 6.
Эталон для сверки: lesson-04. Клонировать его не нужно. Предыдущий: Урок 3. Алфавит, лейблы, формат.
Комментарии