Содержание
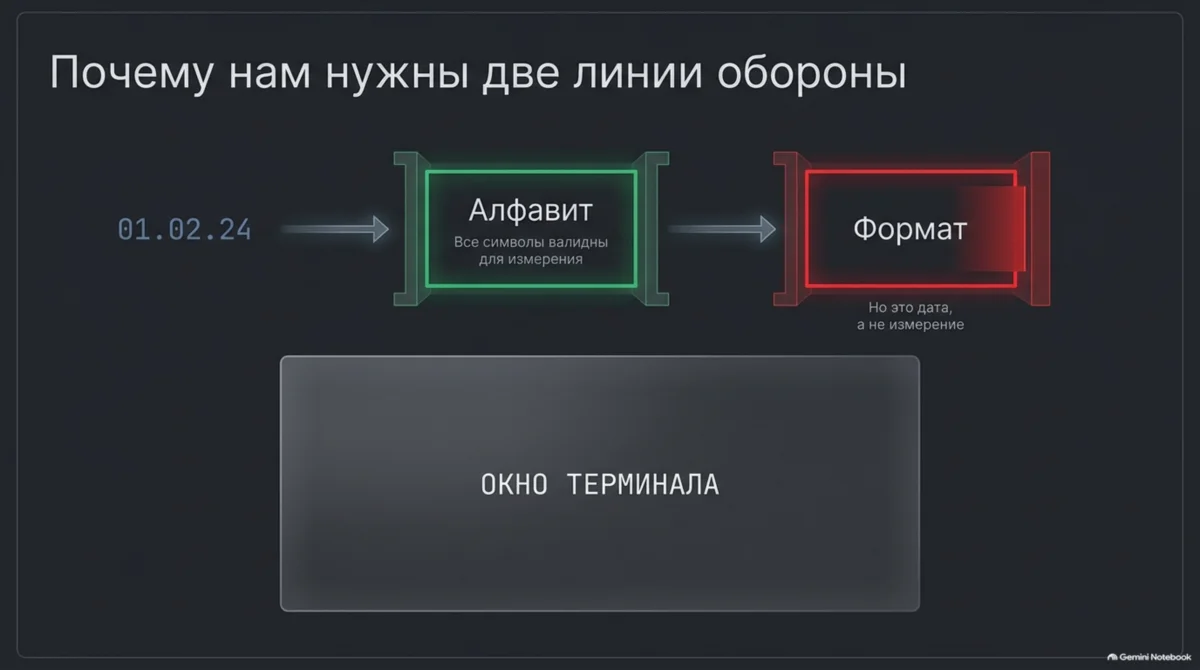
В паспорте две проверки: сначала — что все символы «легальные», потом — что строка похожа на паспорт, а не на штрих-код. Если оставить только первую, дату 01.02.24 можно принять за измерение: после нормализации там одни цифры и запятые. Модель не спорит — она учится на том, что вы ей подали. Ошибка в алфавите или индексах часто не падает с исключением: сеть просто молча читает не то.
В уроке 1 мы собрали лабораторию. В уроке 2 зафиксировали вход [1, 48, 160]. Сегодня серия «Обучаем CNN и CRNN с нуля» договаривается о метках (лейблах): какая строка соответствует кропу клетки.
Четыре слова, которые встретятся дальше:
- Метка — текст, который должен получиться из кропа:
7,3,12/14, пустая строка для пустой клетки. - Алфавит — список допустимых символов для одной задачи на бланке (бумажной форме).
- Класс — один возможный ответ модели в точке выбора: «это
7», «это запятая», «здесь пусто». У каждого класса свой индекс (номер). Когда говорят «12 классов», имеют в виду: модель умеет выбрать один из двенадцати вариантов, не «двенадцать разных нейросетей». Это не класс в смысле ООП и не школьный урок — термин из классификации: сколько рубрик в меню ответа. У детектора «пустая / заполненная клетка» классов два; у читателя строки классов столько, сколько символов в алфавите, плюс служебное пусто. - Пусто (
blank) — отдельный класс: «здесь нет символа». Представьте, что сеть смотрит на кроп по колонкам и на каждой выбирает: цифра, запятая… или «ничего». Вот это «ничего» и есть пусто. В коде и в выводе демо вы увидите английское словоblank— это то же самое; в тексте урока говорим «пусто», чтобы не путать с бланком (листом формы). Пусто — не цифра0в метке105и не пробел: в наших метках пробелов нет, а ноль — обычный символ алфавита с индексом 1 (первый в строке0123456789…). Пусто занимает индекс 0, чтобы цифра «ноль» и «нет символа» никогда не путались. Зачем пусто нужно по смыслу — в уроке 10 (CTC). Сегодня важно одно: место под него уже заложено в нумерации.
На бланке (форме) у нас три типа клеток — три задачи: измерение (measurement), диаметр (diameter), толщина (thickness). У каждой свой алфавит и своё правило формата. Поэтому одной проверки «все символы из списка» мало: нужна вторая линия — формат.
Файлы урока
src/alphabet.py— алфавиты задач, контракт индексов, нормализация, кодирование, проверка формата.src/demo_labels.py— что происходит с сырыми строками на входе пайплайна.tests/test_alphabet.py— двенадцать тестов; они же спецификация.
Файлы кладёте в свой репозиторий из урока 1 и коммитите, когда тесты зелёные. Ниже, в «Напиши сам», все три файла лежат свёрнутыми блоками — разверните и скопируйте. Эталон lesson-03 и заготовка lesson-03-start — те же тексты на GitHub, если удобнее смотреть там.
Предскажи
Раздел «Предскажи» — не экзамен. Вы фиксируете ожидание до запуска, потом сверяете с demo_labels.py и pytest. Особенно полезно угадать, почему дата отклонена не по алфавиту.
Перед запуском запишите ответы:
- Сколько классов (с пусто) будет у задач
measurement,diameterиthickness? - Какой индекс получит символ
,в алфавитеmeasurement? - Строка
01.02.24после нормализации состоит из допустимых символов. Должна ли система принять её как измерение?
Спецификация
Алфавит — контракт модели: какие символы вообще бывают. От него сразу следует число классов — сколько разных ответов может выбрать сеть. Функция num_classes(task) как раз это и считает: длина алфавита плюс один служебный класс — пусто. Это же число — ширина последнего слоя модели (одна «ручка» на каждый класс). Индексы при обучении и при расшифровке должны совпадать до единицы: иначе loss и decode будут смотреть на разные символы под одним номером.
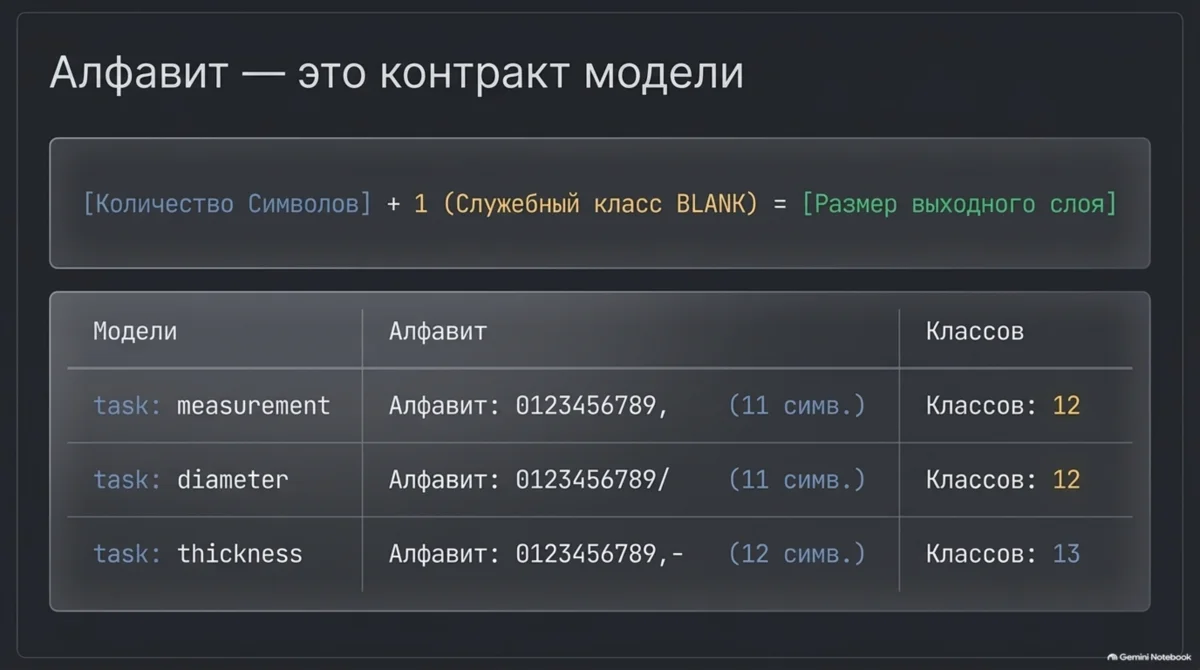
Алфавиты и индексы.
| Задача | Алфавит | Символов | Классов (с пусто) |
|---|---|---|---|
measurement |
0123456789, |
11 | 12 |
diameter |
0123456789/ |
11 | 12 |
thickness |
0123456789,- |
12 | 13 |
Контракт индексов: пусто = 0 (blank в коде), символы нумеруются с 1 в порядке следования в строке алфавита. Индекс класса — то число, которое попадёт в метку для обучения и которое decode превратит обратно в символ.
Пример для measurement и строки 7,3:
- символ
7— восьмой в0123456789,→ индекс 8; - запятая — одиннадцатый символ → индекс 11;
- символ
3— четвёртый → индекс 4.
Итого: 7,3 → [8, 11, 4].
Функции. В эталоне lesson-03-start колонка «готово» уже написана; ваша работа — строки с вы (в заготовке это три блока TODO). В своём репозитории готовые функции тоже набираете — иначе нечему вызывать encode.
| Функция | Что делает | Кто пишет |
|---|---|---|
get_alphabet(task), num_classes(task) |
строка алфавита и число классов; неизвестная задача — ValueError |
готово |
normalize_label(text) |
убрать пробелы, . → ,, разные тире → обычный - |
готово |
encode_text(text, task) |
строка → список индексов; символ вне алфавита — ValueError; пустая строка → [] |
вы |
decode_indices(indices, task) |
индексы → строка; 0, отрицательный или за алфавитом — ValueError |
вы |
FORMAT_PATTERNS |
регулярные выражения форматов по задачам | вы |
validate_format(text, task) |
(ok, причина): сначала алфавит, потом формат |
вы |
Порядок на входе пайплайна (так же будет в генераторе урока 4):
normalize_label— привести сырую строку к канону;validate_format— отсечь мусор;encode_text— получить индексы для модели.
Форматы. Пустая строка допустима для всех задач — это пустая клетка. Правило смотрит уже на нормализованную строку.
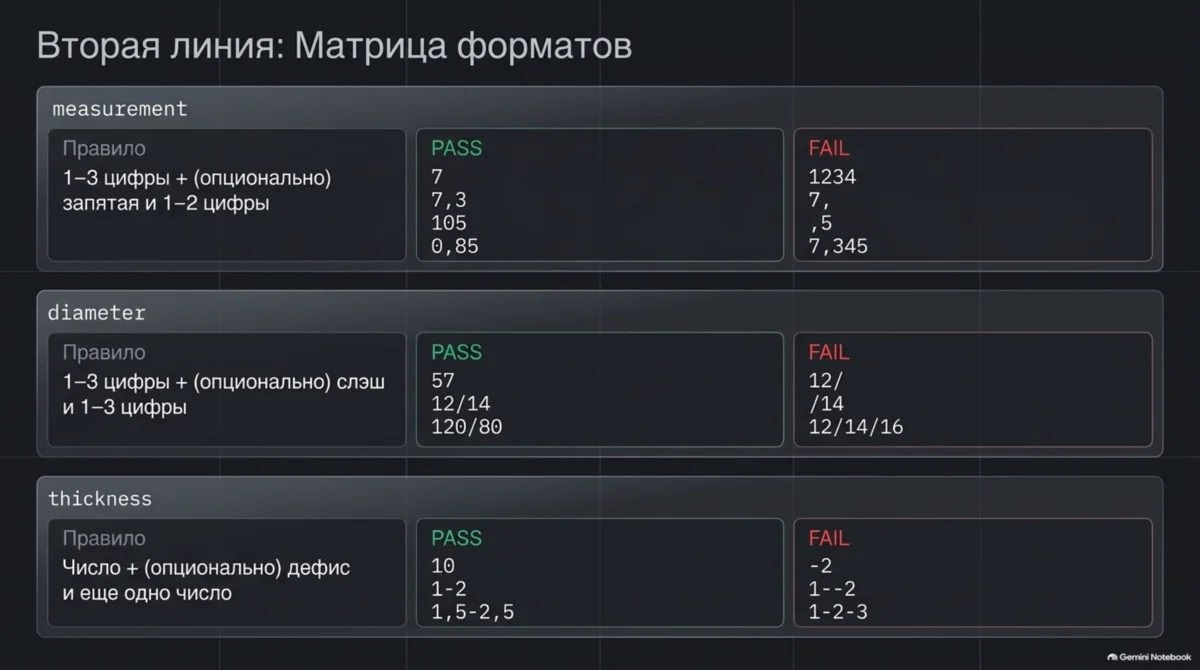
| Задача | Правило простыми словами | Подходят | Не подходят |
|---|---|---|---|
measurement |
целое из 1–3 цифр; опционально запятая и ещё 1–2 цифры | 7, 7,3, 105, 0,85, 123,45 |
1234, 7,, ,5, 7,345, 01,02,24 |
diameter |
целое из 1–3 цифр; опционально / и ещё 1–3 цифры |
57, 12/14, 120/80 |
12/, /14, 12/14/16 |
thickness |
одно «число» или два через дефис; каждое число — 1–2 цифры, опционально с запятой и 1–2 цифрами | 10, 1-2, 1,5-2, 1,5-2,5 |
-2, 1-, 1--2, 1-2-3 |
Причина отказа в validate_format должна содержать слово «алфавит» (символ вне списка) или «формат» (символы свои, форма чужая). Так тесты отличают два вида отказа.
Два решения, которые стоит принять до кода:
encode_textне нормализует строку. Иначе7.3молча превратится в допустимое7,3, и ошибки разметки спрячутся. Нормализация — один раз на входе пайплайна; encode проверяет, что на выходе уже чисто.decode_indicesне принимает пусто. Пусто — не символ текста. Схлопывание повторов и удаление пусто — в уроке 10; сюда доходят только индексы настоящих символов.
Напиши сам
Сначала положите файлы в репозиторий из урока 1. Блоки ниже свёрнуты — разверните и скопируйте. Заготовка alphabet.py как на теге lesson-03-start: готовые функции уже есть, три блока TODO пустые. Можно набрать всё с нуля по спецификации — тесты те же.
Запуск команд — после того как допишете TODO (следующий раздел и блок «Команды»).
src/alphabet.py — заготовка (развернуть)
"""Урок 3 — «напиши сам»: алфавиты, контракт индексов и проверка формата меток.
Что нужно сделать (три пункта TODO ниже), пока не пройдут все тесты:
python -m pytest tests/test_alphabet.py -q
Контракт индексов (общий для всего курса):
blank = 0, символы алфавита нумеруются с 1 в порядке следования в строке.
"""
import re
BLANK_INDEX = 0
ALPHABETS = {
"measurement": "0123456789,",
"diameter": "0123456789/",
"thickness": "0123456789,-",
}
_DASHES = "\u2010\u2011\u2012\u2013\u2014\u2212" # разные «тире» и минус
# --- Готово: можно не трогать ------------------------------------------------
def get_alphabet(task: str) -> str:
try:
return ALPHABETS[task]
except KeyError:
raise ValueError(f"неизвестная задача {task!r}; доступны: {sorted(ALPHABETS)}") from None
def num_classes(task: str) -> int:
"""Размер выходного слоя модели: символы алфавита + blank."""
return len(get_alphabet(task)) + 1
def normalize_label(text: str) -> str:
"""Приводит сырую метку к каноническому виду: без пробелов, ',' вместо '.', обычный '-'."""
text = "".join(text.split())
text = text.replace(".", ",")
for dash in _DASHES:
text = text.replace(dash, "-")
return text
# --- TODO 1: форматы -----------------------------------------------------------
# Для каждой задачи нужен re.compile(...), который проверяется через fullmatch.
# Используйте [0-9], а не \d: \d совпадает и с цифрами других письменностей.
#
# measurement: 1–3 цифры, затем (необязательно) запятая и 1–2 цифры.
# Подходят: 7 7,3 105 0,85 123,45
# diameter: 1–3 цифры, затем (необязательно) косая черта и 1–3 цифры.
# Подходят: 57 12/14 120/80
# thickness: «число» = 1–2 цифры, затем (необязательно) запятая и 1–2 цифры.
# Метка = число, затем (необязательно) дефис и ещё одно число.
# Подходят: 10 1-2 1,5-2 1,5-2,5
#
# Пустая строка (пустая клетка) допустима для всех задач; её обрабатывает
# validate_format, регулярное выражение для неё писать не нужно.
FORMAT_PATTERNS: dict[str, "re.Pattern[str]"] = {}
# --- TODO 2: кодирование -------------------------------------------------------
def encode_text(text: str, task: str) -> list[int]:
"""Строка → список индексов (blank = 0, символы с 1).
Строку заранее нормализует вызывающий код: символ вне алфавита — ValueError.
Пустая строка даёт пустой список.
"""
raise NotImplementedError
def decode_indices(indices, task: str) -> str:
"""Список индексов → строка.
Индекс 0 (blank), отрицательный индекс и индекс за пределами алфавита — ValueError.
"""
raise NotImplementedError
# --- TODO 3: проверка формата --------------------------------------------------
def validate_format(text: str, task: str) -> tuple[bool, str]:
"""Проверяет метку и возвращает (ok, причина).
Порядок проверок:
1. любой символ вне алфавита -> (False, причина со словом «алфавит»);
2. пустая строка -> (True, "");
3. не подходит под формат -> (False, причина со словом «формат»);
4. иначе -> (True, "").
"""
raise NotImplementedErrorsrc/demo_labels.py — развернуть
"""Демо: алфавиты, нормализация, кодирование и проверка формата."""
from alphabet import (
ALPHABETS, BLANK_INDEX, decode_indices, encode_text, get_alphabet,
normalize_label, num_classes, validate_format,
)
CASES = [
("7.3", "measurement"),
("12/14", "diameter"),
("12/14", "measurement"),
("01.02.24", "measurement"),
("7.345", "measurement"),
("1\u20132", "thickness"),
("", "measurement"),
]
def main() -> None:
print(f"blank = {BLANK_INDEX}, символы нумеруются с 1\n")
for task in ALPHABETS:
print(f"{task:<12} алфавит {get_alphabet(task)!r:<16} символов: {len(get_alphabet(task)):>2}"
f" классов с blank: {num_classes(task)}")
print()
for raw, task in CASES:
norm = normalize_label(raw)
try:
ok, reason = validate_format(norm, task)
except NotImplementedError:
print(
"TODO в src/alphabet.py ещё не дописаны "
"(validate_format / encode_text / FORMAT_PATTERNS).\n"
"Сначала доведите тесты до зелёных:\n"
" python -m pytest tests/test_alphabet.py -q\n"
"Демо — после 12 passed (или смотрите эталон lesson-03)."
)
raise SystemExit(1) from None
head = f"{raw!r:<11} {task:<12} → {norm!r:<10}"
if ok:
try:
idx = encode_text(norm, task)
back = decode_indices(idx, task)
except NotImplementedError:
print(
"TODO в src/alphabet.py ещё не дописаны (encode_text / decode_indices).\n"
"Сначала: python -m pytest tests/test_alphabet.py -q"
)
raise SystemExit(1) from None
assert back == norm
print(f"{head} → {idx} → {back!r} OK")
else:
print(f"{head} → REJECT: {reason}")
if __name__ == "__main__":
main()tests/test_alphabet.py — развернуть
import sys
from pathlib import Path
import pytest
sys.path.insert(0, str(Path(__file__).resolve().parents[1] / "src"))
from alphabet import ( # noqa: E402
BLANK_INDEX, decode_indices, encode_text, get_alphabet,
normalize_label, num_classes, validate_format,
)
ACCEPT = {
"measurement": ["", "7", "7,3", "105", "0,85", "123,45", "007"],
"diameter": ["", "57", "12/14", "120/80"],
"thickness": ["", "10", "1-2", "1,5-2", "1,5-2,5", "12-15"],
}
REJECT_FORMAT = {
"measurement": ["1234", "7,", ",5", "7,345", "7,3,1", "01,02,24", "1,2,3"],
"diameter": ["12/", "/14", "12/14/16", "1234", "12/1234"],
"thickness": ["-2", "1-", "1--2", "1-2-3", "123", "1,", "1,5,5"],
}
REJECT_ALPHABET = {
"measurement": ["12/14", "7.3", "abc", "7 3"],
"diameter": ["7,3", "7.3"],
"thickness": ["7/3", "1_2"],
}
def test_blank_is_zero():
assert BLANK_INDEX == 0
assert encode_text("0", "measurement") == [1]
def test_num_classes():
assert num_classes("measurement") == 12
assert num_classes("diameter") == 12
assert num_classes("thickness") == 13
def test_encode_examples():
assert encode_text("7,3", "measurement") == [8, 11, 4]
assert encode_text("12/14", "diameter") == [2, 3, 11, 2, 5]
assert encode_text("1,5-2", "thickness") == [2, 11, 6, 12, 3]
assert encode_text("", "measurement") == []
def test_encode_rejects_foreign_char():
with pytest.raises(ValueError):
encode_text("7.3", "measurement") # точку нормализует вызывающий код
with pytest.raises(ValueError):
encode_text("12/14", "measurement")
def test_decode_roundtrip():
for task, texts in ACCEPT.items():
for text in texts:
assert decode_indices(encode_text(text, task), task) == text
def test_decode_rejects_blank_and_out_of_range():
with pytest.raises(ValueError):
decode_indices([0], "measurement") # blank — не символ
with pytest.raises(ValueError):
decode_indices([12], "measurement") # в алфавите всего 11 символов
with pytest.raises(ValueError):
decode_indices([-1], "measurement")
def test_normalize_label():
assert normalize_label("7.3") == "7,3"
assert normalize_label(" 7, 3 ") == "7,3"
assert normalize_label("1\u20132") == "1-2"
assert normalize_label("01.02.24") == "01,02,24"
assert normalize_label("") == ""
def test_validate_accepts():
for task, texts in ACCEPT.items():
for text in texts:
ok, reason = validate_format(text, task)
assert ok, f"{task}: {text!r} должна приниматься, а отклонена: {reason}"
def test_validate_rejects_by_format():
for task, texts in REJECT_FORMAT.items():
for text in texts:
ok, reason = validate_format(text, task)
assert not ok, f"{task}: {text!r} должна отклоняться"
assert "формат" in reason, f"{task}: {text!r}: причина должна содержать «формат»"
def test_validate_rejects_by_alphabet():
for task, texts in REJECT_ALPHABET.items():
for text in texts:
ok, reason = validate_format(text, task)
assert not ok, f"{task}: {text!r} должна отклоняться"
assert "алфавит" in reason, f"{task}: {text!r}: причина должна содержать «алфавит»"
def test_trap_passes_alphabet_but_not_format():
# Дата после normalize_label целиком состоит из допустимых символов.
text = normalize_label("01.02.24")
assert all(ch in get_alphabet("measurement") for ch in text)
ok, reason = validate_format(text, "measurement")
assert not ok and "формат" in reason
def test_unknown_task():
with pytest.raises(ValueError):
get_alphabet("nope")
with pytest.raises(ValueError):
encode_text("1", "nope")Подсказки:
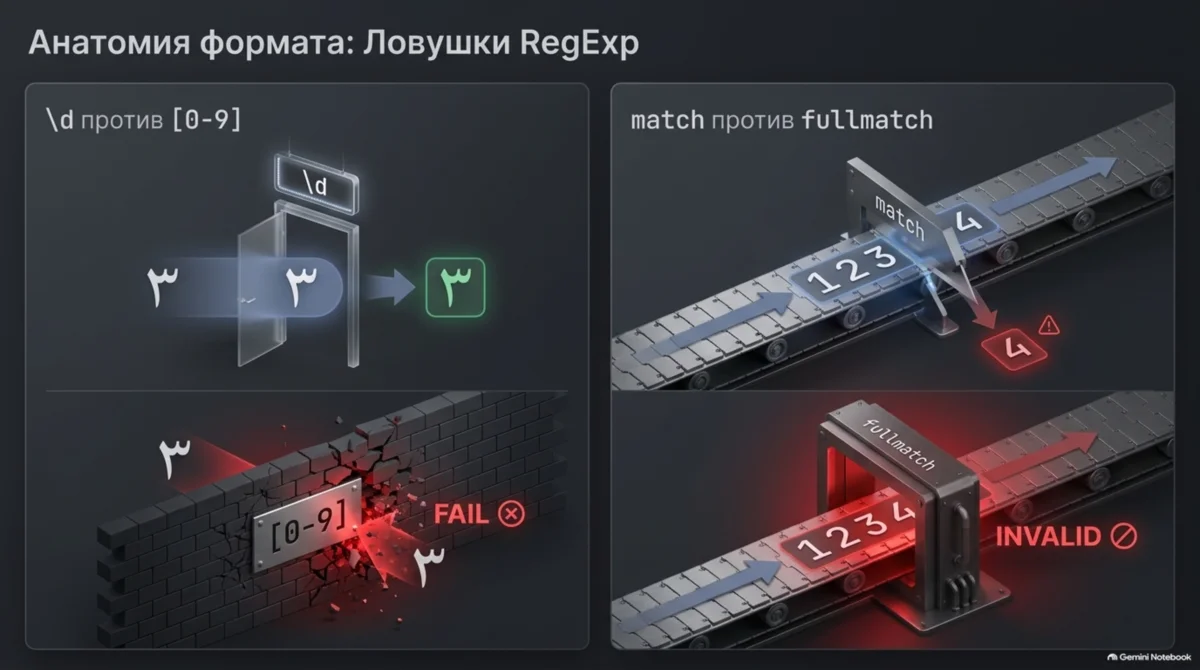
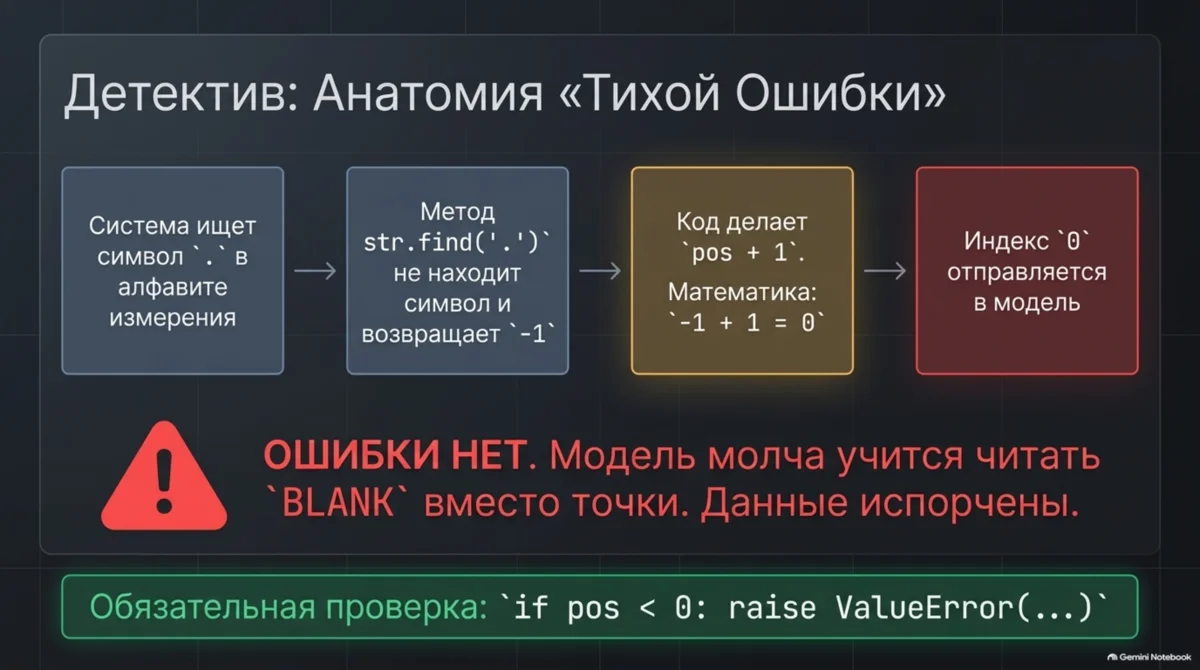
- У
str.findна ненайденный символ —-1. Без проверкиpos + 1даст 0, то есть индекс пусто. Модель получила бы «нет символа» вместо ошибки. Это самая коварная ловушка урока (схема ниже). re.matchпроверяет только начало строки. Для формата нуженfullmatch: иначе1234пройдёт как123с хвостом.- В выражениях пишите
[0-9], не\d: в Python\dсовпадает и с цифрами других письменностей (например арабо-индийской٣).
Упражнение (напиши сам)
Основное — три блока TODO в alphabet.py: FORMAT_PATTERNS, пара encode_text / decode_indices, validate_format. На заготовке pytest сначала даст 10 failed, 2 passed — так и должно быть, пока TODO пустые. Допишите функции и перезапускайте тесты, пока не станет 12 passed.
Бонус: придумайте строку-ловушку — проходит алфавит, но не формат (например лишний разделитель). Добавьте тест в tests/test_alphabet.py (имя вроде test_trap_passes_alphabet_but_not_format).
Когда тесты зелёные — переходите к «Команды» и сверяйте демо с «Ожидаемое». Если застряли, ниже полное решение (лучше открыть после попытки).
Решение src/alphabet.py (откройте после попытки)
Полный файл с тега lesson-03. В комментариях к encode_text — та самая ловушка find → пусто.
"""Алфавиты задач, контракт индексов и проверка формата меток.
Контракт индексов (общий для всего курса):
blank = 0, символы алфавита нумеруются с 1 в порядке следования в строке.
"""
import re
BLANK_INDEX = 0
ALPHABETS = {
"measurement": "0123456789,",
"diameter": "0123456789/",
"thickness": "0123456789,-",
}
# Формат метки поверх алфавита (пустая строка = пустая клетка, допустима всегда).
# Пишем [0-9], а не \d: \d в Python совпадает и с цифрами других письменностей.
FORMAT_PATTERNS = {
"measurement": re.compile(r"[0-9]{1,3}(,[0-9]{1,2})?"),
"diameter": re.compile(r"[0-9]{1,3}(/[0-9]{1,3})?"),
"thickness": re.compile(r"[0-9]{1,2}(,[0-9]{1,2})?(-[0-9]{1,2}(,[0-9]{1,2})?)?"),
}
_DASHES = "\u2010\u2011\u2012\u2013\u2014\u2212" # разные «тире» и минус
def get_alphabet(task: str) -> str:
try:
return ALPHABETS[task]
except KeyError:
raise ValueError(f"неизвестная задача {task!r}; доступны: {sorted(ALPHABETS)}") from None
def num_classes(task: str) -> int:
"""Размер выходного слоя модели: символы алфавита + blank."""
return len(get_alphabet(task)) + 1
def normalize_label(text: str) -> str:
"""Приводит сырую метку к каноническому виду: без пробелов, ',' вместо '.', обычный '-'."""
text = "".join(text.split())
text = text.replace(".", ",")
for dash in _DASHES:
text = text.replace(dash, "-")
return text
def encode_text(text: str, task: str) -> list[int]:
"""Строка → список индексов (blank = 0, символы с 1).
Строку заранее нормализует вызывающий код: символ вне алфавита — ошибка.
"""
alphabet = get_alphabet(task)
indices = []
for ch in text:
pos = alphabet.find(ch) # -1, если символа нет
if pos < 0: # иначе pos+1 даст 0 = blank — коварная ошибка
raise ValueError(f"символ {ch!r} вне алфавита задачи {task!r}")
indices.append(pos + 1) # символы с 1, blank = 0
return indices
def decode_indices(indices, task: str) -> str:
"""Список индексов → строка. Индекс 0 (blank) и выход за алфавит — ошибка."""
alphabet = get_alphabet(task)
chars = []
for i in indices:
if not 1 <= i <= len(alphabet): # blank и «мусор» сюда не входят
raise ValueError(f"индекс {i} недопустим для задачи {task!r} (допустимо 1..{len(alphabet)})")
chars.append(alphabet[i - 1]) # индекс 1 → первый символ алфавита
return "".join(chars)
def validate_format(text: str, task: str) -> tuple[bool, str]:
"""Проверяет метку: сначала алфавит, потом формат. Возвращает (ok, причина)."""
alphabet = get_alphabet(task)
for ch in text:
if ch not in alphabet: # сначала алфавит, потом формат
return False, f"символ {ch!r} вне алфавита"
if text == "":
return True, ""
if FORMAT_PATTERNS[task].fullmatch(text) is None: # match() оставил бы хвост
return False, "формат не соответствует задаче"
return True, ""Что заметить: проверка pos < 0 обязательна; формат — через fullmatch; в регулярках — [0-9], не \d.
Команды
Когда TODO дописаны (или вы сверились с решением), из корня репозитория:
python -m pytest tests/test_alphabet.py -q   # цель: 12 passed
python src/demo_labels.py
Если демо запустить раньше, чем заполнены TODO, скрипт напомнит дописать alphabet.py — это не поломка репозитория.
Ожидаемое
Вывод demo_labels.py на решении (тег lesson-03). Читайте стрелки слева направо: сырая строка → нормализация → индексы или REJECT. В терминале слово blank — это наше пусто (так напечатано в коде демо).
blank = 0, символы нумеруются с 1

measurement  алфавит '0123456789,'    символов: 11  классов с blank: 12
diameter     алфавит '0123456789/'    символов: 11  классов с blank: 12
thickness    алфавит '0123456789,-'   символов: 12  классов с blank: 13

'7.3'       measurement  → '7,3'      → [8, 11, 4] → '7,3'  OK
'12/14'     diameter     → '12/14'    → [2, 3, 11, 2, 5] → '12/14'  OK
'12/14'     measurement  → '12/14'    → REJECT: символ '/' вне алфавита
'01.02.24'  measurement  → '01,02,24' → REJECT: формат не соответствует задаче
'7.345'     measurement  → '7,345'    → REJECT: формат не соответствует задаче
'1–2'       thickness    → '1-2'      → [2, 12, 3] → '1-2'  OK
''          measurement  → ''         → [] → ''  OK
Тесты: 12 passed.
Сверка с «Предскажи»:
- у
measurementиdiameterпо 12 классов, уthickness— 13; - запятая в
measurement— индекс 11; - дата
01.02.24отклонена по формату, не по алфавиту: символы допустимы, форма чужая.
Запомните пару «12 классов у measurement и diameter» — позже в курсе (урок 16) к этому вернёмся. Закоммитьте урок, когда вывод совпал.
Если не так
- Сообщение про TODO из
demo_labels.py(или раньше — tracebackNotImplementedError) — вы запустили демо до дописыванияalphabet.py. Сначала pytest до12 passed. encode_text("7.3", ...)вернул[8, 0, 4]— нет проверки послеfind; добавьтеif pos < 0. Точка вне алфавита measurement превратилась в пусто.1234проходит формат — используетеre.matchвместоfullmatch.- Отклонены
007или123,45— регулярка слишком строгая; сверьте с таблицей форматов (ведущие нули и123,45должны проходить). - Тест на причину отказа падает — в тексте причины должны быть слова «алфавит» или «формат».
ModuleNotFoundError: alphabet— pytest и demo запускайте из корня вашего репозитория.
Чек-лист
-
src/alphabet.py,demo_labels.pyи тесты написаны в вашем репозитории и закоммичены -
demo_labels.pyсовпадает с блоком «Ожидаемое» -
pytest→ 12 passed - Сверены три прогноза из «Предскажи»
FAQ
Что такое «класс» в этом уроке?
Один пункт в меню ответа модели. Для measurement меню такое: пусто, 0, 1, …, 9, , — всего 12 классов. Метка 7,3 — не один класс, а последовательность классов [8, 11, 4]. Детектор пустых клеток (уроки 7–9) выбирает один класс на весь кроп; читатель строки (позже) выбирает класс на каждом шаге вдоль картинки.
Почему пусто — отдельный класс с индексом 0?
Модели чтения строк понадобится ответ «на этой колонке символа нет» — отдельно от цифры 0 в тексте. Если отдать символам индексы с нуля или смешать пусто с «нулём», обучение и расшифровка разъедутся. Поэтому индекс 0 заранее занят под пусто (blank в коде), а цифра 0 живёт с индекса 1. Как пусто участвует в CTC — в уроке 10.
Зачем три разных алфавита, если цифры везде?
На бланке (форме) разные клетки: измерение с десятичной запятой, диаметр со слэшем, толщина с дефисом диапазона. Один «универсальный» алфавит раздует выход модели и смешает форматы — сеть начнёт путать задачи.
Почему normalize_label в эталоне уже написан, а encode — нет?
Нормализация — политика пайплайна («как мы храним метку»). Кодирование и формат — ядро контракта с моделью; его и тренируем писать по спецификации тестов. В своём репозитории normalize_label вы всё равно набираете — просто это не упражнение с ловушками.
Принимаем ли мы 007 как измерение?
Да, если строка уже каноническая: формат разрешает ведущие нули в целой части. Это осознанное решение курса; в проде можно добавить отдельную нормализацию числа.
Можно ли вызывать encode_text на сырой строке с точкой?
Не стоит: получите ValueError или, без проверки find, тихую порчу через пусто. Сначала normalize_label, потом validate_format, потом encode — так же будет в генераторе урока 4.
Почему у measurement и diameter одинаково 12 классов?
Одинаковое число символов в алфавите (11 + пусто). Это пригодится позже, когда будем делить головы модели (урок 16).
Что дальше
Контракт меток готов. Следующий шаг — Урок 4. Синтетический генератор и all.jsonl. Dataset и аугментации — уроки 5–6.
Эталон для сверки: lesson-03. Клонировать его не нужно. Предыдущий: Урок 2. Картинка → тензор.
Комментарии