Содержание
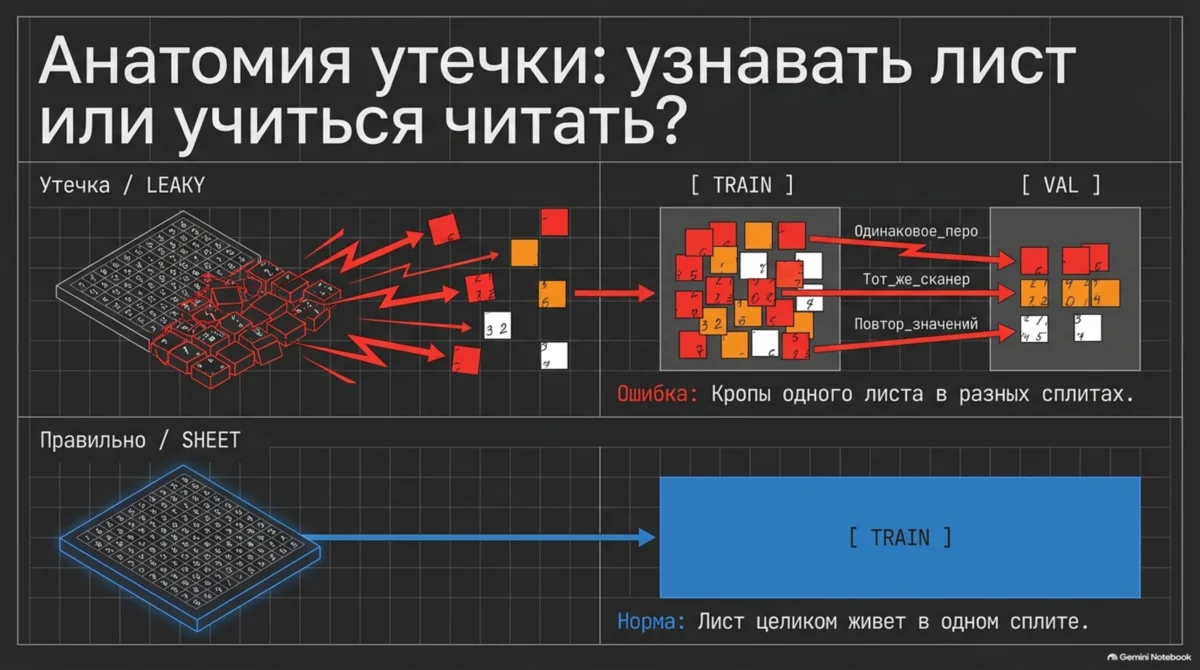
Карты одной колоды нельзя раздать и себе, и сопернику: вы уже знаете масть. С кропами бланка то же самое. Кроп — одна вырезанная клетка. На листе их двадцать, и у всех один group_id: номер этого листа. Клетки похожи: то же перо, та же бумага, тот же сканер, да ещё и значения на листе повторяются. Если часть клеток листа попадёт в train, а часть в val, модель «узнает» лист, а не научится читать. Оценка получится красивой и ложной.
Три части, на которые дальше делится весь набор. train — клетки, на которых модель учится: их она видит, по ним подбираются веса. val — клетки для настройки. В обучение они не входят. По ним выбирают порог и лучший чекпоинт, то есть сохранённые веса. test — клетки для одного итогового числа. Пока идёт настройка, в test не заглядывают. Уроки 1–3 говорят «обучение» про сам процесс. В уроке 2 фраза «train и prod» про другое: подготовка картинки при обучении и в рабочей системе. С этого урока train, val и test — имена трёх частей данных.
Как это выглядит на одном листе. Три клетки содержат 12,4, написаны одним пером. Две уехали в train, третья осталась в val. Проверка видит знакомые чернила и вспоминает число. Клетку с другого листа, где этого пера не было, так не прочитать. В коде деление по-прежнему называется split: отсюда split.json и слово «сплит» ниже. Это то же самое деление.
В уроке 4 мы собрали 5000 кропов с group_id. Сегодня серия «Обучаем CNN и CRNN с нуля» делит их по листам и показывает утечку своими глазами.
Файлы урока
src/split_groups.py— деление групп на train/val/test, чтение данных, страты и запись файлов.src/verify_split.py— проверка разбиения: пересечения групп, потери, размер test.src/baselines.py— первая простая модель, 1-NN по пикселям (в уроке 7 к ней добавятся другие). Она не учится читать: для проверочной клетки ищет в train самую похожую картинку по яркости пикселей и копирует её текст.experiments/leakage_demo.py— демо утечки.experiments/make_leaky_split.py— намеренно портит разбиение (делит по кропам).tests/test_split_groups.py,tests/test_baselines.py,tests/test_verify_split.py— тесты.
Полный код восьми файлов — в разделе «Напиши сам»: разверните блок и скопируйте в свой репозиторий из урока 1. Коммитьте, когда тесты зелёные. Эталон lesson-05 открывайте в браузере только если вывод не сходится. Заготовка lesson-05-start — тот же эталон на полпути, не рабочая копия.
Предскажи
Раздел «Предскажи» — не экзамен. Сначала фиксируете ожидание, потом сверяете с leakage_demo.py.
В вопросах три слова. Точность — доля проверочных клеток, у которых текст совпал с ответом ближайшего соседа. Сосед — обучающая клетка с самой похожей яркостью пикселей. Модель копирует чужой текст. Value-кроп — заполненная клетка, в файле у неё is_empty: false и непустой текст. Пустая клетка в это демо не входит. Recall в третьем вопросе — доля заполненных клеток, которые не пометили пустыми. Формула, которая превращает «ноль ошибок» в осторожную нижнюю границу, будет в разделе «Идеи». Сейчас достаточно записать число.
Перед запуском запишите ответы:
- Модель одна и та же (ближайший сосед по пикселям), данные те же. Val выбран либо случайно среди кропов, либо по листам. Во сколько раз изменится точность: почти не изменится, примерно в 1.5 раза или в 3 раза и больше?
- В случайном делении по кропам: у какой доли val-кропов ближайший сосед окажется на том же листе?
- Сколько value-кропов должно быть в test, чтобы при нуле ошибок можно было доказать, что recall не ниже 0.99 (нижняя граница 95 %-го интервала Уилсона)?
Идеи урока
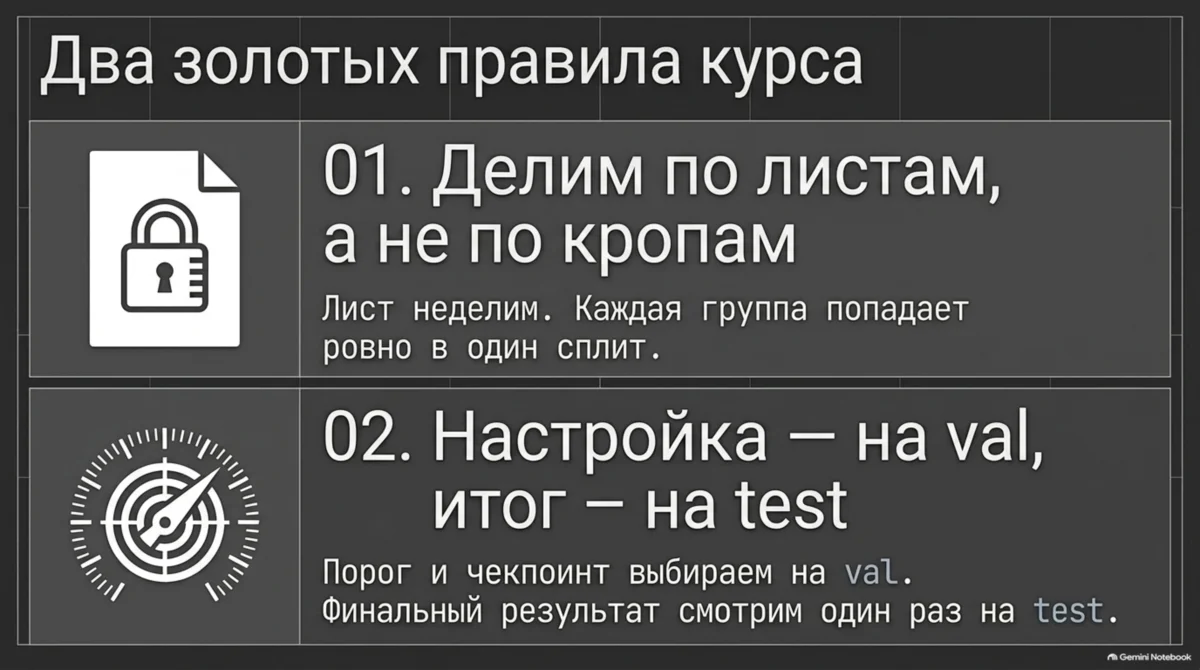
Сегодня у нас два правила, которые мы будем соблюдать до конца курса:
- Делим по группам (листам), а не по кропам. Лист целиком живёт в одном из сплитов.
- val — для настройки, test — для итогового числа. Порог и лучший чекпоинт выбираем на val, а финальный результат один раз смотрим на test.
Порядок такой: сначала увидим утечку своими глазами на наших данных, потом напишем деление по листам и проверку, и в конце специально сломаем разбиение, чтобы убедиться, что проверка это ловит.
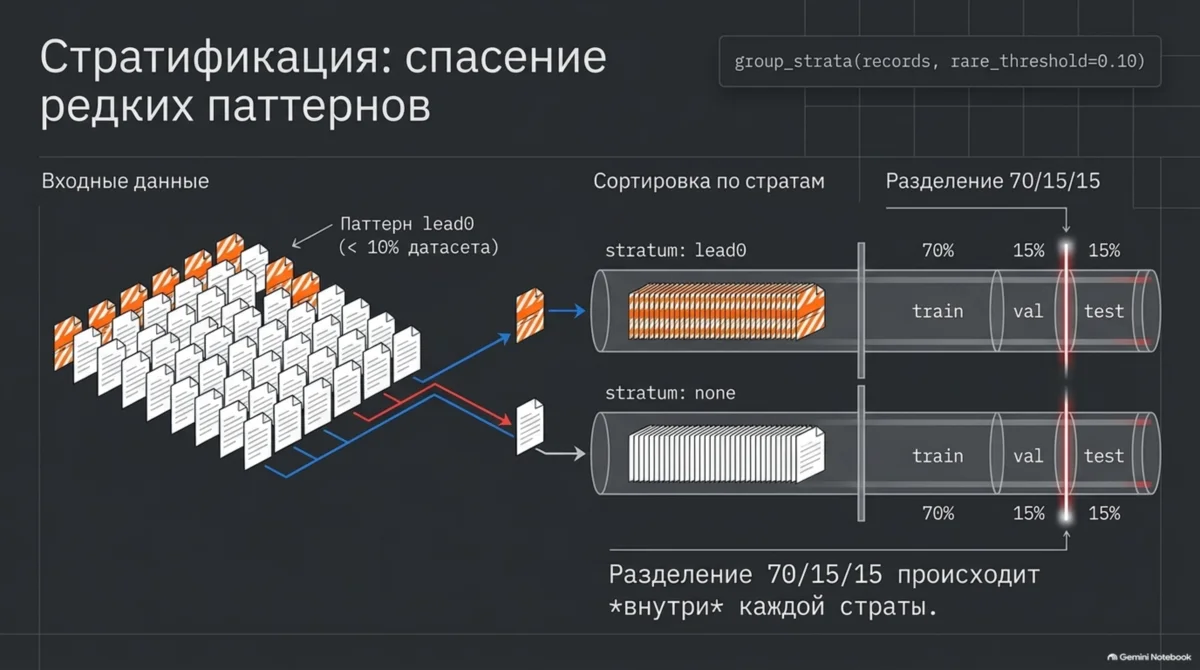
Страты. Делить группы просто случайно можно, но тогда редкий паттерн (в нашем датасете это 0,xx) может случайно оказаться в основном в одном сплите. Поэтому у каждой группы есть страта: какие редкие паттерны на листе встречаются. Паттерн считается редким, если его доля среди value-кропов меньше 10 %. У нас это lead0: 98 листов содержат такие значения, 152 нет. Внутри каждой страты листы делятся по тем же долям 70/15/15.
Паттерн — это форма записи, не само число. 12,4 (одна цифра после запятой), 12,40 (две) и 12 (целое) встречаются часто. Редкая запись в этих данных начинается с нуля перед запятой: 0,7 или 0,42. Код зовёт её lead0. Страта листа равна lead0, если на нём есть хотя бы одна такая заполненная клетка, и none, если нет. Пустые клетки в страту не входят: у них нет текста, который можно классифицировать.
Зачем резать внутри страты, а не всю стопку из 250 листов сразу. Иначе все 98 листов с 0,… могут уехать в train. В val не останется ни одного примера этой формы, и оценка «модель умеет читать числа меньше единицы» будет пустой. Отдельные 70/15/15 в каждой кучке оставляют и обычные листы, и листы с ведущим нулём во всех трёх частях.
Арифметика размера test. Нижняя граница интервала Уилсона при 0 ошибках на n объектах равна n / (n + z²), где z = 1.96. Чтобы она достигла 0.99, нужно n ≥ 381.
Ноль ошибок на n клетках значит только «на этих n всё верно». Это ещё не обещание на любые бланки. Формула смотрит пессимистично: квадрат 1,96 около 3,84, то есть к n успехам как будто добавляют несколько невидимых провалов и делят на новую сумму. На 100 идеальных клетках граница 100 / 103,84 ≈ 0,963. До 0,99 она дотягивает лишь при n ≥ 381. Recall здесь — доля заполненных клеток, которые не пометили пустыми. Если в test их меньше 381, правило «recall ≥ 0,99» нельзя подтвердить даже идеальным прогоном.
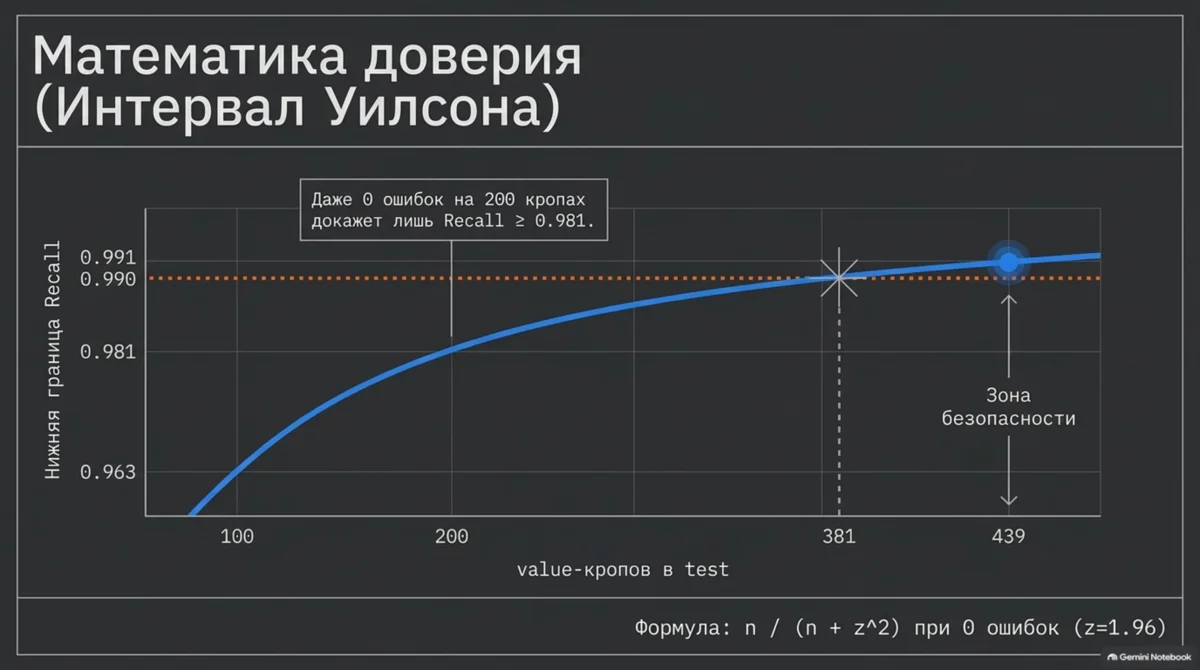
| value-кропов в test | нижняя граница при 0 ошибок |
|---|---|
| 100 | 0.963 |
| 200 | 0.981 |
| 381 | 0.990 |
| 439 (наш test) | 0.991 |
Значит, при 200 кропах правило «recall ≥ 0.99» проверить нельзя в принципе. Отсюда 250 листов в уроке 4: у нас в test 38 листов и 439 value-кропов. verify_split.py предупредит, если test окажется меньше.
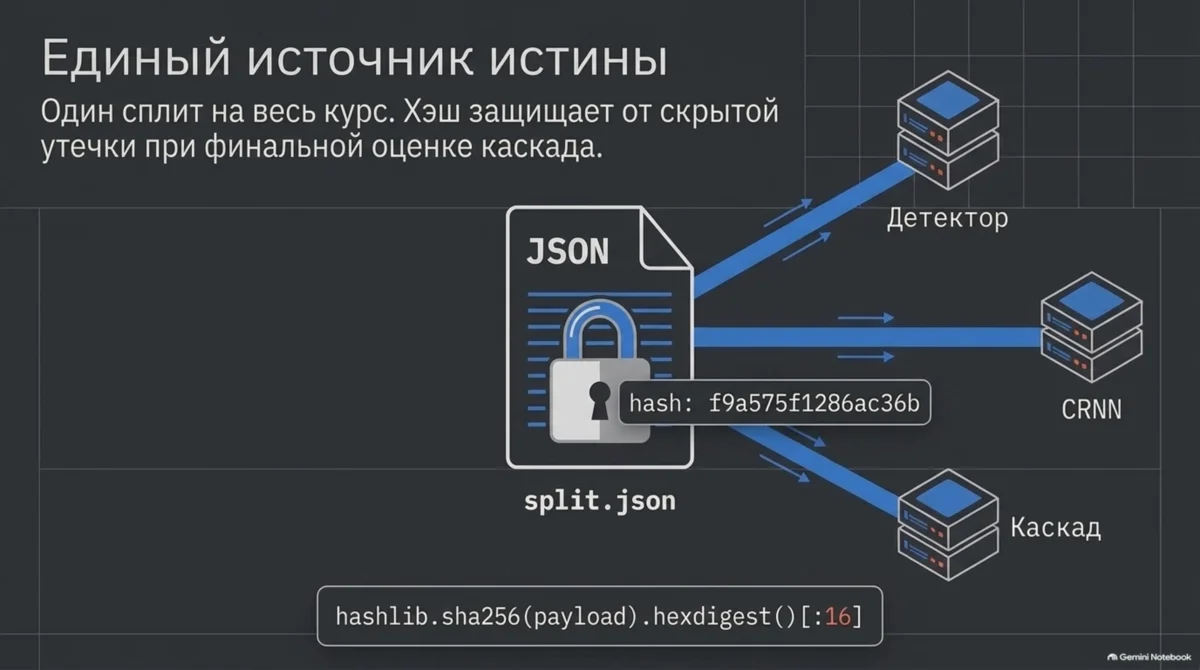
Один split.json на весь курс. Все модели (детектор, CRNN, каскад) должны читать один и тот же файл разбиения. В нём лежат списки групп и hash разбиения: по нему в уроке 18 мы проверим, что две модели учились на одном сплите.
Рядом команда пишет train.jsonl, val.jsonl и test.jsonl. Строка кропа переезжает целиком в файл своего листа: клетка не делится пополам. В split.json три списка group_id, зерно seed, доли и сколько листов в каждой страте. Hash — первые 16 знаков SHA-256 от этих трёх списков. Переложите один лист из val в test, и отпечаток изменится. Сверяют именно его, а не глазами две простыни имён.
Спецификация
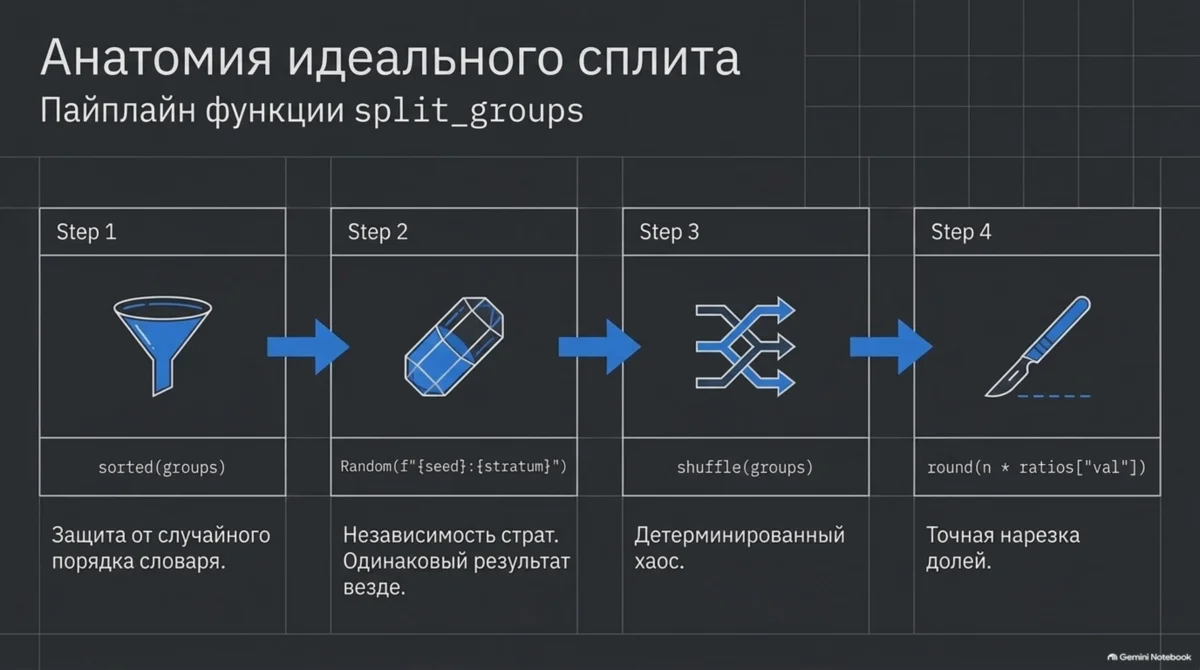
Функция split_groups(strata, ratios, seed) принимает словарь {group_id: страта} и доли {"train": 0.70, "val": 0.15, "test": 0.15}. Требования (их проверяют тесты):
- Каждая группа попадает ровно в один сплит; ничего не теряется и не добавляется.
- Результат детерминирован и не зависит от порядка групп во входном словаре.
- Разные
seedдают разные разбиения. - Деление стратифицировано: внутри страты группы перемешиваются генератором
random.Random(f"{seed}:{страта}"), затемvalполучаетround(n * доля_val)групп,testполучаетround(n * доля_test), остальное идёт вtrain. Страта из одной группы целиком уходит вtrain. - Некорректные доли (нет ключей, отрицательные, сумма не равна 1) дают
ValueError. Эту проверку делаетcheck_ratiosв том же файле — её тоже пишете вы. - Возвращается
{"train": [...], "val": [...], "test": [...]}, списки отсортированы.
Как требование 4 выглядит на короткой страте. Две группы и доля val 0,15: round(2 × 0,15) = round(0,3) = 0. Обе группы уходят в train. Одна группа даёт тот же ноль, поэтому страта из одной группы целиком в train. На полной страте lead0 из 98 листов round(98 × 0,15) = round(14,7) = 15, а int отрежет до 14. Тест на пропорциях терпит разницу в один лист, но hash полного split.json уже не совпадёт с блоком «Ожидаемое».
Имя страты входит в seed, чтобы у каждой кучки был свой генератор. У кучки lead0 это random.Random("42:lead0"), у кучки none — свой, "42:none". Перемешивание листов с ведущим нулём не зависит от того, сколько обычных листов лежит рядом. Одно и то же число без имени страты дало бы обеим кучкам одну последовательность.
Напиши сам
Сначала положите файлы в репозиторий из урока 1. Блоки ниже свёрнуты — разверните и скопируйте в указанные пути. Как устроено деление — в разделе «Спецификация»; длинный код берёте из блоков, а не с тега на GitHub.
Нужен data/processed из урока 4. Команды урока запускайте после того, как файлы на месте.
src/split_groups.py — деление по листам (121 строка) (развернуть)
"""Сплит train/val/test ПО ГРУППАМ (листам), а не по кропам.
Зачем: кропы одного листа похожи друг на друга (перо, бумага, сканер) и часто повторяют
значения. Если часть листа попала в train, а часть в val, модель «узнаёт» лист, а не учится
читать, и оценка получается завышенной (утечка).
Результат: split.json (списки групп, один на все модели курса) и train/val/test.jsonl.
"""
import argparse
import hashlib
import json
import random
import sys
from collections import Counter
from pathlib import Path
from patterns import label_pattern
SPLITS = ("train", "val", "test")
def check_ratios(ratios: dict) -> None:
if set(ratios) != set(SPLITS):
raise ValueError(f"ratios должен содержать ключи {SPLITS}, получено {sorted(ratios)}")
if any(v < 0 for v in ratios.values()):
raise ValueError("доли не могут быть отрицательными")
if abs(sum(ratios.values()) - 1.0) > 1e-6:
raise ValueError(f"доли должны давать в сумме 1, получено {sum(ratios.values())}")
def split_groups(strata: dict[str, str], ratios: dict[str, float], seed: int = 42) -> dict[str, list[str]]:
"""Делит группы на train/val/test, сохраняя пропорции страт.
strata: {group_id: страта}; ratios: {"train": .., "val": .., "test": ..}.
Внутри каждой страты группы перемешиваются отдельным генератором
random.Random(f"{seed}:{страта}"), затем val получает round(n * доля_val) групп,
test — round(n * доля_test), остальное — train.
Возвращает {"train": [...], "val": [...], "test": [...]}, списки отсортированы.
"""
check_ratios(ratios)
result: dict[str, list[str]] = {name: [] for name in SPLITS}
for stratum in sorted(set(strata.values())):
groups = sorted(g for g, s in strata.items() if s == stratum)
random.Random(f"{seed}:{stratum}").shuffle(groups)
n = len(groups)
n_val = round(n * ratios["val"])
n_test = round(n * ratios["test"])
result["val"] += groups[:n_val]
result["test"] += groups[n_val:n_val + n_test]
result["train"] += groups[n_val + n_test:]
return {name: sorted(ids) for name, ids in result.items()}
# --- Дальше всё готово: чтение данных, страты, запись файлов ------------------------
def read_jsonl(path) -> list[dict]:
with open(path, encoding="utf-8") as f:
return [json.loads(line) for line in f]
def group_strata(records: list[dict], rare_threshold: float = 0.10) -> dict[str, str]:
"""Страта группы = какие редкие паттерны в ней встречаются (редкий: < 10 % value-кропов)."""
counts = Counter(label_pattern(r["text"], r["task"]) for r in records if not r["is_empty"])
total = sum(counts.values())
rare = {p for p, c in counts.items() if c / total < rare_threshold}
found: dict[str, set] = {}
for r in records:
found.setdefault(r["group_id"], set())
if not r["is_empty"]:
pattern = label_pattern(r["text"], r["task"])
if pattern in rare:
found[r["group_id"]].add(pattern)
return {g: "+".join(sorted(s)) or "none" for g, s in found.items()}
def split_hash(split: dict) -> str:
"""Отпечаток разбиения: по нему позже проверим, что две модели учились на одном сплите."""
payload = json.dumps({name: split[name] for name in SPLITS}, sort_keys=True)
return hashlib.sha256(payload.encode()).hexdigest()[:16]
def main() -> None:
ap = argparse.ArgumentParser()
ap.add_argument("--src", default="data/processed", help="папка с all.jsonl")
ap.add_argument("--out", default="data/processed")
ap.add_argument("--val-ratio", type=float, default=0.15)
ap.add_argument("--test-ratio", type=float, default=0.15)
ap.add_argument("--seed", type=int, default=42)
args = ap.parse_args()
records = read_jsonl(Path(args.src) / "all.jsonl")
ratios = {"train": round(1 - args.val_ratio - args.test_ratio, 6),
"val": args.val_ratio, "test": args.test_ratio}
strata = group_strata(records)
split = split_groups(strata, ratios, args.seed)
out = Path(args.out)
out.mkdir(parents=True, exist_ok=True)
meta = {"version": 1, "seed": args.seed, "ratios": ratios,
"strata": dict(sorted(Counter(strata.values()).items())),
"hash": split_hash(split), **split}
(out / "split.json").write_text(json.dumps(meta, indent=1, ensure_ascii=False), encoding="utf-8")
owner = {g: name for name in SPLITS for g in split[name]}
for name in SPLITS:
with open(out / f"{name}.jsonl", "w", encoding="utf-8") as f:
for r in records:
if owner[r["group_id"]] == name:
f.write(json.dumps(r, ensure_ascii=False) + "\n")
print(f"split.json: hash={meta['hash']}, seed={args.seed}")
for name in SPLITS:
crops = [r for r in records if owner[r["group_id"]] == name]
value = sum(not r["is_empty"] for r in crops)
print(f" {name:<5} групп {len(split[name]):>3} кропов {len(crops):>4} "
f"(value {value}, empty {len(crops) - value})")
print(f"страты (групп): {meta['strata']}")
if __name__ == "__main__":
sys.exit(main())src/verify_split.py — проверка разбиения (91 строка) (развернуть)
"""Проверка разбиения: нет пересечений групп, ничего не потеряно, test достаточно велик."""
import argparse
import json
import math
import sys
from pathlib import Path
from split_groups import SPLITS, read_jsonl, split_hash
Z = 1.96 # 95 %-й доверительный интервал
TARGET_RECALL = 0.99
def min_value_crops(target: float = TARGET_RECALL, z: float = Z) -> int:
"""Сколько value-кропов нужно, чтобы при 0 ошибок нижняя граница Уилсона достигла target.
Нижняя граница при 0 ошибок на n объектах: n / (n + z^2).
"""
return math.ceil(target * z * z / (1 - target))
def verify(data_dir) -> tuple[list[str], list[str], list[dict]]:
"""Возвращает (ошибки, предупреждения, строки таблицы)."""
data_dir = Path(data_dir)
errors: list[str] = []
warnings: list[str] = []
all_records = read_jsonl(data_dir / "all.jsonl")
part = {name: read_jsonl(data_dir / f"{name}.jsonl") for name in SPLITS}
groups = {name: {r["group_id"] for r in part[name]} for name in SPLITS}
for i, a in enumerate(SPLITS):
for b in SPLITS[i + 1:]:
common = groups[a] & groups[b]
if common:
sample = ", ".join(sorted(common)[:3])
errors.append(f"УТЕЧКА: {len(common)} групп есть и в {a}, и в {b} (например, {sample})")
ids = [r["id"] for name in SPLITS for r in part[name]]
if len(ids) != len(set(ids)):
errors.append("есть кропы, попавшие в несколько сплитов")
missing = {r["id"] for r in all_records} - set(ids)
if missing:
errors.append(f"потеряно кропов: {len(missing)} (есть в all.jsonl, нет ни в одном сплите)")
split_path = data_dir / "split.json"
if split_path.exists():
meta = json.loads(split_path.read_text(encoding="utf-8"))
for name in SPLITS:
if set(meta[name]) != groups[name]:
errors.append(f"split.json не совпадает с {name}.jsonl")
if meta.get("hash") != split_hash(meta):
errors.append("hash в split.json не соответствует спискам групп")
else:
errors.append("нет split.json")
table = []
for name in SPLITS:
value = sum(not r["is_empty"] for r in part[name])
table.append({"split": name, "groups": len(groups[name]), "crops": len(part[name]),
"value": value, "empty": len(part[name]) - value})
need = min_value_crops()
test_value = next(row["value"] for row in table if row["split"] == "test")
if test_value < need:
warnings.append(f"в test {test_value} value-кропов; для проверки recall ≥ {TARGET_RECALL} "
f"нужно хотя бы {need} (иначе даже 0 ошибок не докажет цель)")
return errors, warnings, table
def main() -> None:
ap = argparse.ArgumentParser()
ap.add_argument("--data-dir", default="data/processed")
args = ap.parse_args()
errors, warnings, table = verify(args.data_dir)
print(f"{'split':<6}{'groups':>8}{'crops':>8}{'value':>8}{'empty':>8}")
for row in table:
print(f"{row['split']:<6}{row['groups']:>8}{row['crops']:>8}{row['value']:>8}{row['empty']:>8}")
for w in warnings:
print("WARN:", w)
if errors:
for e in errors:
print("ERROR:", e)
print("verify_split: FAIL")
sys.exit(1)
test_value = next(row["value"] for row in table if row["split"] == "test")
print(f"пересечения групп: нет; test value-кропов: {test_value} (нужно ≥ {min_value_crops()})")
print("verify_split: OK")
if __name__ == "__main__":
main()src/baselines.py — 1-NN по пикселям (42 строки) (развернуть)
"""Простые базовые модели: с ними сравниваем всё остальное (в уроке 7 добавятся ещё)."""
from pathlib import Path
import numpy as np
from image_to_tensor import preprocess_array
def load_features(records: list[dict], image_root, pool: int = 2) -> np.ndarray:
"""Кропы → матрица [N, D]: препроцессинг урока 2 и усреднение блоками pool×pool."""
rows = []
for r in records:
arr = preprocess_array(Path(image_root) / r["image"])[0] # [48, 160]
if pool > 1:
h, w = arr.shape
arr = arr.reshape(h // pool, pool, w // pool, pool).mean(axis=(1, 3))
rows.append(arr.reshape(-1))
return np.stack(rows).astype(np.float32)
class OneNN:
"""Один ближайший сосед по евклидову расстоянию между пикселями."""
def fit(self, X: np.ndarray, y) -> "OneNN":
self.X = np.asarray(X, dtype=np.float32)
self.y = list(y)
self._sq = (self.X ** 2).sum(axis=1)
return self
def nearest(self, Q: np.ndarray, chunk: int = 256) -> np.ndarray:
"""Индекс ближайшего обучающего объекта для каждой строки Q."""
Q = np.asarray(Q, dtype=np.float32)
out = []
for i in range(0, len(Q), chunk):
part = Q[i:i + chunk]
# |q - x|^2 = |q|^2 - 2 q·x + |x|^2; |q|^2 для argmin не нужен
dist = self._sq[None, :] - 2.0 * part @ self.X.T
out.append(dist.argmin(axis=1))
return np.concatenate(out)
def predict(self, Q: np.ndarray) -> list:
return [self.y[i] for i in self.nearest(Q)]experiments/leakage_demo.py — демо утечки (69 строк) (развернуть)
"""Демо утечки: одна и та же модель (1-NN по пикселям), два способа сделать val.
LEAKY — val выбран случайно среди кропов (листы перемешаны между train и val).
SHEET — val из split.json: листы val модель не видела.
Размеры train и val в обоих случаях одинаковы, меняется только способ деления.
"""
import argparse
import json
import random
import sys
from collections import Counter
from pathlib import Path
import numpy as np
sys.path.insert(0, str(Path(__file__).resolve().parents[1] / "src"))
from baselines import OneNN, load_features # noqa: E402
from split_groups import read_jsonl # noqa: E402
def evaluate(train: list[dict], val: list[dict], image_root, pool: int) -> dict:
X_train = load_features(train, image_root, pool)
X_val = load_features(val, image_root, pool)
model = OneNN().fit(X_train, [r["text"] for r in train])
idx = model.nearest(X_val)
pred = [model.y[i] for i in idx]
exact = float(np.mean([p == r["text"] for p, r in zip(pred, val)]))
same_sheet = float(np.mean([train[i]["group_id"] == r["group_id"] for i, r in zip(idx, val)]))
seen = {r["text"] for r in train}
ceiling = float(np.mean([r["text"] in seen for r in val]))
return {"exact": exact, "same_sheet": same_sheet, "ceiling": ceiling}
def main() -> None:
ap = argparse.ArgumentParser()
ap.add_argument("--data-dir", default="data/processed")
ap.add_argument("--seed", type=int, default=0)
ap.add_argument("--pool", type=int, default=2, help="усреднение пикселей блоками (ускоряет)")
args = ap.parse_args()
data_dir = Path(args.data_dir)
manifest = json.loads((data_dir / "manifest.json").read_text(encoding="utf-8"))
image_root = manifest["image_root"]
train = [r for r in read_jsonl(data_dir / "train.jsonl") if not r["is_empty"]]
val = [r for r in read_jsonl(data_dir / "val.jsonl") if not r["is_empty"]]
# честный вариант: val из split.json
honest = evaluate(train, val, image_root, args.pool)
# утечка: тот же пул кропов, но val выбран случайно и того же размера
pool_records = train + val
order = list(range(len(pool_records)))
random.Random(args.seed).shuffle(order)
leaky_val = [pool_records[i] for i in order[:len(val)]]
leaky_train = [pool_records[i] for i in order[len(val):]]
leaky = evaluate(leaky_train, leaky_val, image_root, args.pool)
top = Counter(r["text"] for r in train).most_common(1)[0]
chance = float(np.mean([r["text"] == top[0] for r in val]))
print(f"train {len(train)} кропов, val {len(val)} кропов (только value)")
print(f"наивный ответ «всегда {top[0]!r}»: exact {chance:.3f}\n")
print(f"{'':<8}{'exact':>8}{'сосед с того же листа':>26}{'потолок*':>11}")
print(f"{'LEAKY':<8}{leaky['exact']:>8.3f}{leaky['same_sheet']:>26.3f}{leaky['ceiling']:>11.3f}")
print(f"{'SHEET':<8}{honest['exact']:>8.3f}{honest['same_sheet']:>26.3f}{honest['ceiling']:>11.3f}")
print("* потолок: доля val-кропов, значение которых вообще встречается в train")
if __name__ == "__main__":
main()experiments/make_leaky_split.py — намеренно портит разбиение (43 строк) (развернуть)
"""Намеренно портит разбиение: делит по КРОПАМ, а не по группам (для проверки verify_split)."""
import argparse
import json
import random
import shutil
import sys
from pathlib import Path
sys.path.insert(0, str(Path(__file__).resolve().parents[1] / "src"))
from split_groups import SPLITS, read_jsonl, split_hash # noqa: E402
def main() -> None:
ap = argparse.ArgumentParser()
ap.add_argument("--src", default="data/processed")
ap.add_argument("--out", default="data/processed-leaky")
ap.add_argument("--seed", type=int, default=0)
args = ap.parse_args()
src, out = Path(args.src), Path(args.out)
out.mkdir(parents=True, exist_ok=True)
shutil.copy(src / "manifest.json", out / "manifest.json")
shutil.copy(src / "all.jsonl", out / "all.jsonl")
records = read_jsonl(src / "all.jsonl")
random.Random(args.seed).shuffle(records) # перемешиваем кропы, а не листы
n = len(records)
cuts = {"train": records[: int(n * 0.70)],
"val": records[int(n * 0.70): int(n * 0.85)],
"test": records[int(n * 0.85):]}
meta = {"version": 1, "seed": args.seed}
for name in SPLITS:
with open(out / f"{name}.jsonl", "w", encoding="utf-8") as f:
for r in cuts[name]:
f.write(json.dumps(r, ensure_ascii=False) + "\n")
meta[name] = sorted({r["group_id"] for r in cuts[name]})
meta["hash"] = split_hash(meta)
(out / "split.json").write_text(json.dumps(meta, indent=1, ensure_ascii=False), encoding="utf-8")
print(f"испорченный сплит записан в {out}")
if __name__ == "__main__":
main()tests/test_split_groups.py — тесты деления (84 строки) (развернуть)
import random
import sys
from pathlib import Path
import pytest
sys.path.insert(0, str(Path(__file__).resolve().parents[1] / "src"))
from split_groups import split_groups # noqa: E402
RATIOS = {"train": 0.70, "val": 0.15, "test": 0.15}
def make_strata(n_rare: int = 100, n_common: int = 150) -> dict[str, str]:
strata = {f"g{i:03d}": "rare" for i in range(n_rare)}
strata.update({f"g{n_rare + i:03d}": "common" for i in range(n_common)})
return strata
def test_partition_no_overlap_nothing_lost():
strata = make_strata()
result = split_groups(strata, RATIOS, seed=42)
assert set(result) == {"train", "val", "test"}
all_ids = result["train"] + result["val"] + result["test"]
assert len(all_ids) == len(set(all_ids)), "группа попала в несколько сплитов"
assert set(all_ids) == set(strata), "часть групп потеряна или появилась лишняя"
def test_deterministic_and_independent_of_input_order():
strata = make_strata(30, 40)
shuffled_items = list(strata.items())
random.Random(1).shuffle(shuffled_items)
shuffled = dict(shuffled_items)
assert split_groups(strata, RATIOS, seed=7) == split_groups(strata, RATIOS, seed=7)
assert split_groups(strata, RATIOS, seed=7) == split_groups(shuffled, RATIOS, seed=7)
def test_different_seed_gives_different_split():
strata = make_strata()
assert split_groups(strata, RATIOS, seed=1) != split_groups(strata, RATIOS, seed=2)
def test_overall_proportions():
result = split_groups(make_strata(), RATIOS, seed=42) # 250 групп
assert abs(len(result["val"]) - 37.5) <= 3
assert abs(len(result["test"]) - 37.5) <= 3
assert abs(len(result["train"]) - 175) <= 6
def test_stratified_each_stratum_keeps_proportions():
strata = make_strata(100, 150)
result = split_groups(strata, RATIOS, seed=42)
for stratum, n in (("rare", 100), ("common", 150)):
for name, ratio in RATIOS.items():
count = sum(1 for g in result[name] if strata[g] == stratum)
assert abs(count - n * ratio) <= 1, f"{stratum}/{name}: {count} вместо ≈{n * ratio:.1f}"
def test_tiny_stratum_goes_to_train():
strata = make_strata(1, 20) # в страте rare одна группа: round(0.15) = 0
result = split_groups(strata, RATIOS, seed=42)
assert "g000" in result["train"]
def test_lists_are_sorted():
result = split_groups(make_strata(), RATIOS, seed=42)
for ids in result.values():
assert ids == sorted(ids)
def test_zero_test_ratio_is_allowed():
ratios = {"train": 0.85, "val": 0.15, "test": 0.0}
result = split_groups(make_strata(), ratios, seed=42)
assert result["test"] == []
assert len(result["train"]) + len(result["val"]) == 250
def test_bad_ratios_raise():
strata = make_strata(5, 5)
with pytest.raises(ValueError):
split_groups(strata, {"train": 0.5, "val": 0.2, "test": 0.2}, seed=1) # сумма ≠ 1
with pytest.raises(ValueError):
split_groups(strata, {"train": 0.8, "val": 0.2}, seed=1) # нет test
with pytest.raises(ValueError):
split_groups(strata, {"train": 1.2, "val": -0.1, "test": -0.1}, seed=1) # отрицательныеtests/test_baselines.py — тесты 1-NN (39 строк) (развернуть)
import sys
import tempfile
from pathlib import Path
import numpy as np
from PIL import Image
sys.path.insert(0, str(Path(__file__).resolve().parents[1] / "src"))
from baselines import OneNN, load_features # noqa: E402
def test_one_nn_picks_nearest_point():
X = np.array([[0.0, 0.0], [10.0, 10.0], [0.0, 10.0]], dtype=np.float32)
model = OneNN().fit(X, ["a", "b", "c"])
Q = np.array([[1.0, 1.0], [9.0, 9.0], [1.0, 9.0]], dtype=np.float32)
assert model.predict(Q) == ["a", "b", "c"]
def test_one_nn_is_exact_on_training_points():
rng = np.random.default_rng(0)
X = rng.normal(size=(50, 8)).astype(np.float32)
labels = [str(i) for i in range(50)]
assert OneNN().fit(X, labels).predict(X) == labels
def test_chunking_does_not_change_result():
rng = np.random.default_rng(1)
X = rng.normal(size=(40, 6)).astype(np.float32)
Q = rng.normal(size=(30, 6)).astype(np.float32)
model = OneNN().fit(X, range(40))
assert (model.nearest(Q, chunk=7) == model.nearest(Q, chunk=1000)).all()
def test_load_features_shape():
with tempfile.TemporaryDirectory() as d:
Image.new("L", (100, 40), 230).save(Path(d) / "a.png")
records = [{"image": "a.png"}, {"image": "a.png"}]
assert load_features(records, d, pool=2).shape == (2, 24 * 80)
assert load_features(records, d, pool=1).shape == (2, 48 * 160)tests/test_verify_split.py — тесты проверки (78 строк) (развернуть)
import json
import sys
import tempfile
from pathlib import Path
sys.path.insert(0, str(Path(__file__).resolve().parents[1] / "src"))
from split_groups import split_hash # noqa: E402
from verify_split import min_value_crops, verify # noqa: E402
def make_records() -> list[dict]:
records = []
for g in range(6):
for n in range(4):
empty = n % 2 == 1
records.append({"id": f"g{g}_{n}", "image": f"g{g}/{n}.png", "text": "" if empty else "7,3",
"group_id": f"g{g}", "task": "measurement", "is_empty": empty})
return records
def write_dir(d, parts: dict, split_lists: dict | None = None, tamper_hash: bool = False) -> None:
d = Path(d)
records = make_records()
write = lambda name, rows: (d / name).write_text(
"".join(json.dumps(r, ensure_ascii=False) + "\n" for r in rows), encoding="utf-8")
write("all.jsonl", records)
for name, groups in parts.items():
write(f"{name}.jsonl", [r for r in records if r["group_id"] in groups])
lists = split_lists or {name: sorted(groups) for name, groups in parts.items()}
meta = dict(lists)
meta["hash"] = "bad" if tamper_hash else split_hash(meta)
(d / "split.json").write_text(json.dumps(meta), encoding="utf-8")
GOOD = {"train": {"g0", "g1", "g2", "g3"}, "val": {"g4"}, "test": {"g5"}}
def test_min_value_crops_matches_wilson_arithmetic():
n = min_value_crops()
assert n == 381
assert n / (n + 1.96 ** 2) >= 0.99 > (n - 1) / (n - 1 + 1.96 ** 2)
def test_good_split_has_no_errors():
with tempfile.TemporaryDirectory() as d:
write_dir(d, GOOD)
errors, warnings, table = verify(d)
assert errors == []
assert warnings, "test слишком мал: ожидали предупреждение"
assert [row["split"] for row in table] == ["train", "val", "test"]
def test_group_in_two_splits_is_reported_as_leak():
parts = {"train": {"g0", "g1", "g2", "g3"}, "val": {"g3", "g4"}, "test": {"g5"}}
with tempfile.TemporaryDirectory() as d:
write_dir(d, parts)
errors, _, _ = verify(d)
assert any("УТЕЧКА" in e and "train" in e and "val" in e for e in errors), errors
def test_lost_crops_are_reported():
parts = {"train": {"g0", "g1", "g2"}, "val": {"g4"}, "test": {"g5"}} # g3 нигде нет
with tempfile.TemporaryDirectory() as d:
write_dir(d, parts)
errors, _, _ = verify(d)
assert any("потеряно" in e for e in errors), errors
def test_tampered_split_json_is_reported():
with tempfile.TemporaryDirectory() as d:
write_dir(d, GOOD, tamper_hash=True)
errors, _, _ = verify(d)
assert any("hash" in e for e in errors), errors
with tempfile.TemporaryDirectory() as d:
lists = {"train": ["g0", "g1", "g2"], "val": ["g3", "g4"], "test": ["g5"]} # не совпадает с jsonl
write_dir(d, GOOD, split_lists=lists)
errors, _, _ = verify(d)
assert any("не совпадает" in e for e in errors), errorsПодсказки:
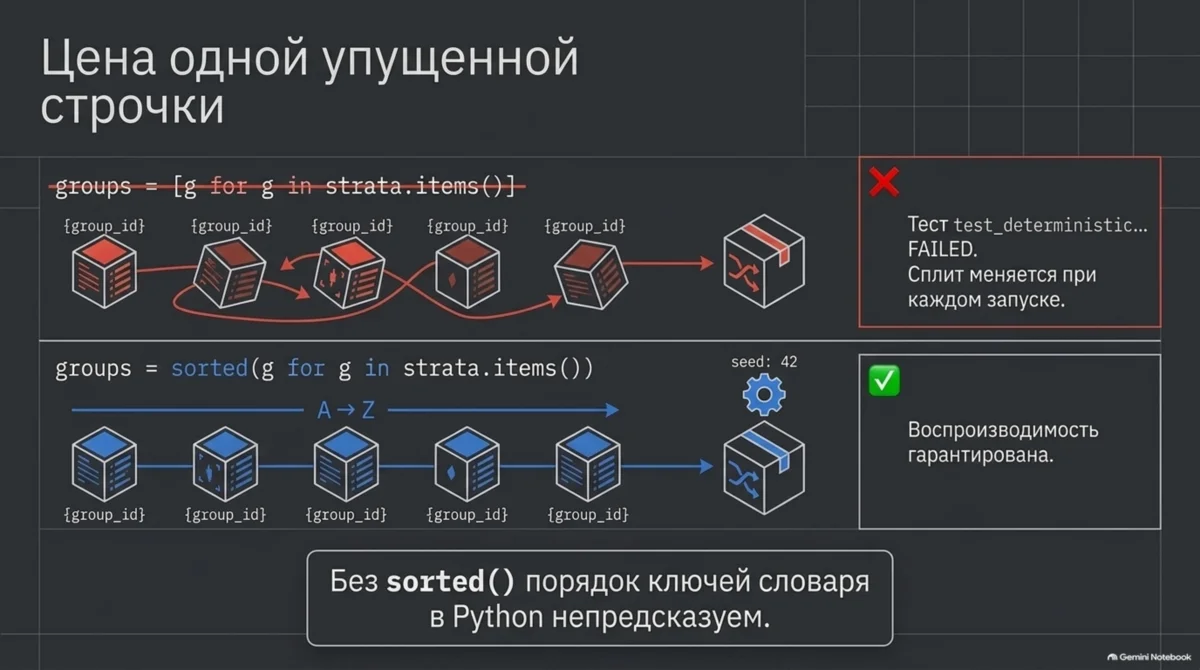
- Что произойдёт, если перемешать группы в порядке словаря? А если сначала их отсортировать?
- Для детерминированного перемешивания используйте
random.Random(строка).shuffle(список). round(n * доля)может округлить 0.15 для маленькой страты до нуля. Спецификация это допускает.
shuffle с одним seed — это фиксированная перестановка позиций, не имён. Словарь, который начинается с sheet_0001, и словарь, который начинается с sheet_0000, дают разный старт. Одна и та же перестановка унесёт в val разные листы. sorted перед shuffle закрепляет старт: сначала sheet_0000, потом sheet_0001. После разрезания списки ещё раз сортируют, уже для записи в ответ. Без первого sorted тест порядка падает, даже если ответ в конце отсортирован.
Команды
Окружение и репозиторий из урока 1. Если data/processed ещё нет — сначала команды урока 4.
python src/split_groups.py --src data/processed --out data/processed --val-ratio 0.15 --test-ratio 0.15
python src/verify_split.py --data-dir data/processed
python experiments/leakage_demo.py
python experiments/make_leaky_split.py --src data/processed --out data/processed-leaky
python src/verify_split.py --data-dir data/processed-leaky
python -m pytest tests/test_split_groups.py tests/test_baselines.py tests/test_verify_split.py -q
Smoke
Те же команды на маленьком датасете урока 4 (data/processed-smoke):
python src/split_groups.py --src data/processed-smoke --out data/processed-smoke
python src/verify_split.py --data-dir data/processed-smoke
python experiments/leakage_demo.py --data-dir data/processed-smoke
python -m pytest tests/test_split_groups.py tests/test_baselines.py tests/test_verify_split.py -q
На маленьком датасете verify_split напечатает предупреждение про размер test: это нормально.
Ожидаемое
Деление и проверка на теге lesson-05 (seed 42, данные урока 4):
split.json: hash=f9a575f1286ac36b, seed=42
  train групп 174  кропов 3480  (value 2056, empty 1424)
  val   групп  38  кропов  760  (value 473, empty 287)
  test  групп  38  кропов  760  (value 439, empty 321)
страты (групп): {'lead0': 98, 'none': 152}

split   groups   crops   value   empty
train      174    3480    2056    1424
val         38     760     473     287
test        38     760     439     321
пересечения групп: нет; test value-кропов: 439 (нужно ≥ 381)
verify_split: OK
Демо утечки смотрит только на заполненные клетки. Картинку приводит к размеру из урока 2 и усредняет соседние пиксели блоками 2×2, чтобы поиск шёл быстрее. Для каждой клетки val ищется клетка train с ближайшей яркостью и копируется её текст. LEAKY заново тасует те же кропы train и val и заново отрезает val того же размера, уже по клеткам, не по листам. SHEET оставляет val из split.json: этих листов в train нет. Число клеток в обеих строках одно и то же, меняется только состав.
train 2056 кропов, val 473 кропов (только value)
наивный ответ «всегда '8'»: exact 0.002

           exact     сосед с того же листа   потолок*
LEAKY      0.323                     0.431      0.698
SHEET      0.108                     0.000      0.459
* потолок: доля val-кропов, значение которых вообще встречается в train
Как читать колонки. exact — доля val, где скопированный текст совпал с верным. «Сосед с того же листа» — доля val, у которой этот сосед лежит на том же group_id. «Потолок» — доля val, чей текст вообще встречается в train. Сосед умеет только копировать увиденный текст, поэтому exact не бывает выше потолка. На честном делении потолок 0,459: больше половины проверочных чисел в обучении ни разу не написаны. При утечке потолок 0,698, потому что повторы с того же листа уже лежат в train.
Строка «всегда '8'» — самый частый текст в train. Даже он верен лишь на 0,2 % val. Разрыв LEAKY и SHEET не из того, что модель угадала популярное число.
Тесты: 18 passed.
Сравните с предсказаниями.
- Разрыв примерно в три раза. LEAKY: 0.323. SHEET: 0.108. Одна и та же модель, те же данные.
- 43 % val-кропов находят соседа на том же листе при случайном делении. При делении по листам это 0 по построению.
- 381 value-кроп. У нас 439, запас есть.
Откуда берётся разрыв. Первая причина: соседний кроп того же листа похож по стилю. Вторая: значения на листе повторяются, поэтому при случайном делении «потолок» вырастает (0.698 против 0.459).
Миниатюра второй причины. На листе три заполненные клетки: 12,4, 12,4 и 7,1. Деление по кропам оставляет одну 12,4 в train, близнец попадает в val. Сосед копирует 12,4, и строка считается «известной». Деление по листам уносит весь лист в val. Если 12,4 больше нигде не написано, сосед не может его выдать: такого текста в train нет.
Две оговорки. Первая: 1-NN слабая модель — важны направление и порядок разрыва, а не абсолютные цифры. Вторая: на честном сплите результат на val 0.108, а на test (другие 38 листов) 0.091 — обычный разброс между наборами листов.
Разбор поломки: сплит по кропам
Запустите make_leaky_split.py, а затем verify_split.py на испорченной папке:
split   groups   crops   value   empty
train      250    3500    2073    1427
val        242     750     451     299
test       238     750     444     306
ERROR: УТЕЧКА: 242 групп есть и в train, и в val (например, sheet_0000, sheet_0001, sheet_0002)
ERROR: УТЕЧКА: 238 групп есть и в train, и в test (например, sheet_0000, sheet_0001, sheet_0002)
ERROR: УТЕЧКА: 230 групп есть и в val, и в test (например, sheet_0000, sheet_0001, sheet_0002)
verify_split: FAIL
Смотрите на колонку groups. Листов всего 250, а в строках 250, 242 и 238. Сумма 730 больше числа листов: один group_id посчитан в нескольких частях. На листе 20 кропов, скрипт тасует кропы и режет их примерно 70/15/15. В train попадает хотя бы одна клетка каждого листа, поэтому там все 250 групп. В val и test заходит большинство тех же листов. Сама запись make_leaky_split.py завершается без ошибки.
Код завершения 1. Это первая намеренная поломка курса: verify_split — не формальность. Такую проверку стоит запускать каждый раз, когда вы пересобираете датасет или сплит. Сам make_leaky_split.py ошибок не выдаёт: его «успех» ничего не значит, пока не пройдена проверка.
Упражнение (напиши сам)
Файлы урока целиком лежат в разделе «Напиши сам».
Дополнительно: запустите make_leaky_split.py и verify_split.py на испорченной папке и убедитесь, что проверка падает. Затем исправьте испорченную папку одной командой (заново запустите split_groups.py на ней) и убедитесь, что проверка снова проходит.
Если не так
NotImplementedError. В файл попала заготовка с тегаlesson-05-start, а не полный код из блока «Напиши сам».test_stratified_each_stratum_keeps_proportionsпадает. Скорее всего, вы округляете иначе (intилиfloorвместоround) или делите все группы разом, а не по стратам.test_deterministic_and_independent_of_input_orderпадает. Вы не отсортировали группы перед перемешиванием.FileNotFoundError: train.jsonl. Сначала запуститеsplit_groups.py.WARN: в test … value-кропов. На маленьком смоук-датасете это нормально. На полном — вы сгенерировали меньше 250 листов.- Демо утечки медленное или не хватает памяти. Добавьте
--pool 4: картинки будут усредняться блоками 4×4. ModuleNotFoundError. Запускайте из корня вашего репозитория; скрипты вexperiments/сами добавляютsrc/в путь.
Чек-лист
- Восемь файлов урока скопированы в ваш репозиторий и закоммичены
-
split_groups.py+verify_split.py→ OK, hash совпадает с ожидаемым при seed 42 -
leakage_demo.pyпоказывает разрыв LEAKY ≫ SHEET -
make_leaky_split+ verify → FAIL с «УТЕЧКА» - pytest → 18 passed
- Сверены три прогноза из «Предскажи»
FAQ
Почему не делить просто train_test_split по кропам со стратификацией по метке?
Стратификация по тексту выровняет долю строки 12,4 в train и в val, но две клетки одного листа всё равно окажутся по разные стороны. Утечку стиля листа это не лечит. Нужна единица деления = group_id.
Зачем hash в split.json уже сейчас?
В уроке 18 каскад склеит детектор и CRNN. Если у моделей разные сплиты, оценка каскада врёт. Hash — короткая проверка «мы смотрим на одно и то же разбиение».
Почему 1-NN, а не сразу CNN?
CNN появится в уроке 7. Слабая модель здесь — свидетель: она показывает механизм утечки (сосед с того же листа, потолок повторов), не конкурируя за качество OCR.
Что делать, если verify_split падает после моих правок генератора?
Не игнорировать. Пересоберите all.jsonl, заново запустите split_groups.py, снова verify_split. Пока FAIL — в обучение не идём.
Можно ли держать test меньше 381 value-кропов?
Можно для отладки (smoke). Для заявления «recall ≥ 0.99 при 0 ошибках» — нет: математика Уилсона не даст нижней границы 0.99.
Почему рядом с split_groups сразу пишем проверку и демо?
Функция деления — ядро урока, но без verify_split и демо утечки не видно, сработал ли сплит. Их тоже копируете из блоков «Напиши сам» в этом уроке. Эталон смотрите, только если скрипт падает или цифры не сходятся.
Что дальше
Честный сплит готов. Следующий урок — Урок 6. Dataset и аугментации. CNN — урок 7.
Эталон для сверки: lesson-05. Клонировать его не нужно. Предыдущий: Урок 4. Синтетический генератор.
Комментарии