

Содержание
На обучении модель видит одни и те же кропы много раз. Если каждый раз пиксели совпадают один в один, она может запомнить этот конкретный снимок: наклон пера, яркость сканера, место цифры в клетке. Новый бланк будет чуть другим. Клетку отсканируют с наклоном на градус, чернила окажутся бледнее, снимок смажется. Для глаза это та же шестёрка. Для модели, которая выучила ровно те пиксели, это уже другая картинка, и на новом бланке она ошибается.
Аугментация показывает ей такие варианты заранее. Из одного кропа она делает несколько похожих копий: небольшой поворот, сдвиг, более бледные чернила, лёгкое размытие. Подпись клетки остаётся прежней, поэтому модель учит цифру, а не удачный кадр. Включать это будем только на списке train. На val и test картинка идёт как есть: по ним мы проверяем чтение нового листа. Искусственный шум в эту проверку не входит.
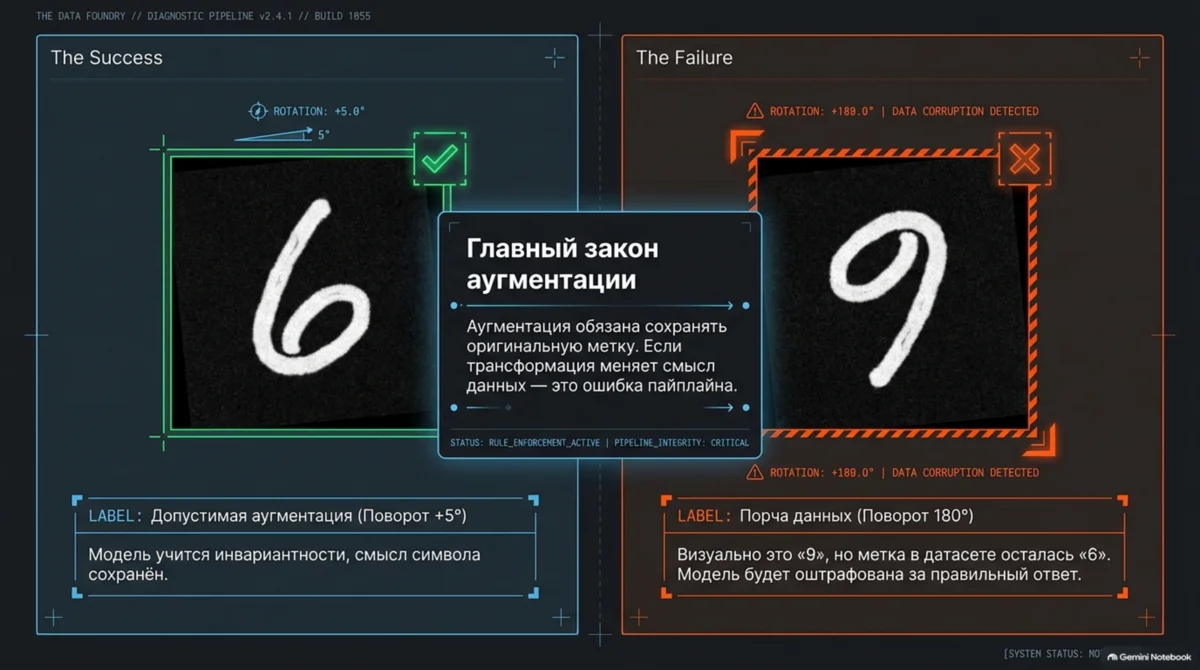
Поворот при этом нельзя брать любой. Поверните кроп с шестёркой на 180°. На картинке получается девятка. В файле разметки строка так и остаётся «6». Модель учится отвечать «шесть», глядя на девятку. Подпись больше не совпадает с тем, что видно на картинке, и такая копия портит данные.
В уроке 5 каждый лист целиком попал в один из трёх списков: train, val или test. Модель берёт кропы из такого списка пачкой. Пачку называют батч. Сегодня серия «Обучаем CNN и CRNN с нуля» собирает эту пачку кодом. CropDataset открывает файл кропа и готовит его теми же шагами, что в уроке 2. Цвет убирается. Картинка целиком вписывается в прямоугольник высотой 48 пикселей и шириной 160, пропорции цифры при этом не сплющиваются. Яркость каждого пикселя становится дробью от 0 до 1. Получается таблица формы [1, 48, 160]. Первое число означает один канал яркости, без цвета. Дальше идут 48 строк и 160 столбцов. Чернила в этой таблице близки к 1, бумага и пустые поля по краям близки к 0. Перед обучением аугментация меняет эти числа. Текст подписи она оставляет как был.
Файлы урока
Шесть файлов дописываете в репозиторий из урока 1. Полный текст лежит ниже, в свёрнутых блоках. Эталон lesson-06 открывайте в браузере только если сетка или pytest не сходятся.
src/datasets/__init__.pyделает папку пакетом. Внутри одна строка-докстринг. Без этого файла Python не считаетdatasetsпакетом.src/datasets/crop_dataset.py—CropDatasetи сборка батча: для чтения строки и для детектора пустой клетки.src/augment.py— два стиля,augment_defaultиaugment_printed.experiments/show_augment_grid.py— сетка 4×4: исходный кроп и 15 его копий.tests/test_augment.py,tests/test_dataset.py— тесты. Их тоже копируете: урок проверяет не «картинка выглядит нормально», а правила, которые глазами легко пропустить.
Предскажи
Раздел «Предскажи» не экзамен. Запишите ответ до сеток и pytest, потом сверьте с разделом «Ожидаемое».
Число 3480 — размер train из урока 5: 174 листа, 3480 кропов. Столько строк лежит в train.jsonl.
В третьем вопросе эпоха означает один полный проход по списку train. Что делает номер этого прохода, разобрано ниже, в идеях урока.
- Что станет с кропом
6, если повернуть его на 180°: сохранится ли метка? - Сколько секунд займёт один проход по
trainв одном процессе: без аугментации и со стилемprinted? Порядка секунды, около пяти секунд или около половины минуты? - Одному кропу дважды дали одни и те же зерно, эпоху и индекс. Аугментация получится одинаковой или разной? А если сменить эпоху?
Идеи урока
Загрузчику батчей достаточно двух методов. DataLoader из PyTorch сам нарезает список на пачки. У объекта, который ему передали, он спрашивает только две вещи. __len__ отвечает, сколько кропов в списке. __getitem__(i) отдаёт кроп номер i: картинку и подпись. Если эти два метода есть, загрузчик может идти по списку. Строка class CropDataset(torch.utils.data.Dataset) нам не нужна: пишем просто class CropDataset. Базовый класс PyTorch даёт ещё несколько вспомогательных методов, и в уроке мы их не вызываем.
Картинки и подписи внутри него остаются массивами NumPy, обычными таблицами чисел. Тензор PyTorch появляется позже, когда пачка уже собрана. Функция to_torch оборачивает эти таблицы, и строка import torch стоит только внутри неё. Тесты, которые проверяют размер картинки и текст подписи, поэтому запускаются без PyTorch. Единственный тест, который сам строит DataLoader, без установленного PyTorch пропускается.
Четыре поля описывают одну и ту же клетку. Кроме имени кропа id и картинки image, __getitem__ возвращает ещё четыре поля. Все они про содержимое одной клетки бланка, поэтому имена легко перепутать. Различаются они вопросом, на который отвечают. text хранит строку из файла, например 12,4. У пустой клетки там пустая строка. target хранит ту же строку числами алфавита: она понадобится, когда модель будет читать текст целиком. label и is_empty саму цифру не хранят. Они отвечают только, пустая ли клетка. label делает это числом: 0, если текст есть, и 1, если клетка пустая. is_empty делает это значением True или False.
| Поле | Смысл |
|---|---|
id |
идентификатор кропа |
image |
массив [1, 48, 160], float32 |
text |
строка из файла разметки. У пустой клетки это '' |
target |
та же строка индексами алфавита из урока 3. Понадобится чтению строки |
label |
0, если в клетке есть текст, и 1, если клетка пустая. Это ответ детектора, не сама цифра |
is_empty |
то же, что label, только булево значение |
label == 1 значит «пусто». В уроках 7–9 вероятность пустой клетки — вероятность этого класса. Ноль значит «в клетке есть значение».
Обычный путь к строке «12,4» такой: разрезать кроп на знаки и подписать каждый кусок отдельно. У нас таких разрезов нет. В файле лежит вся строка, и не отмечено, какой столбец картинки относится к единице, какой к двойке, а какой к запятой. Обучение чтению в такой ситуации сокращают до CTC. Это первые буквы английского названия Connectionist Temporal Classification. Первое слово значит «нейросеть». Второе значит «по шагам времени». Третье значит «выбор символа на каждом шаге». Модель идёт по картинке столбец за столбцом и сама сопоставляет столбцы со знаками. Функцию, которая считает ошибку этого сопоставления, разберём в уроке 10. Сейчас нужна только форма батча, которую эта функция ждёт: цели всех кропов склеены в один вектор targets, а длины лежат рядом в target_lengths. Пустая клетка даёт длину 0. Это ответ «ничего не написано». Отдельный символ пустоты для такой клетки не заводится. Длина совпадает с числом символов в text, включая запятую.
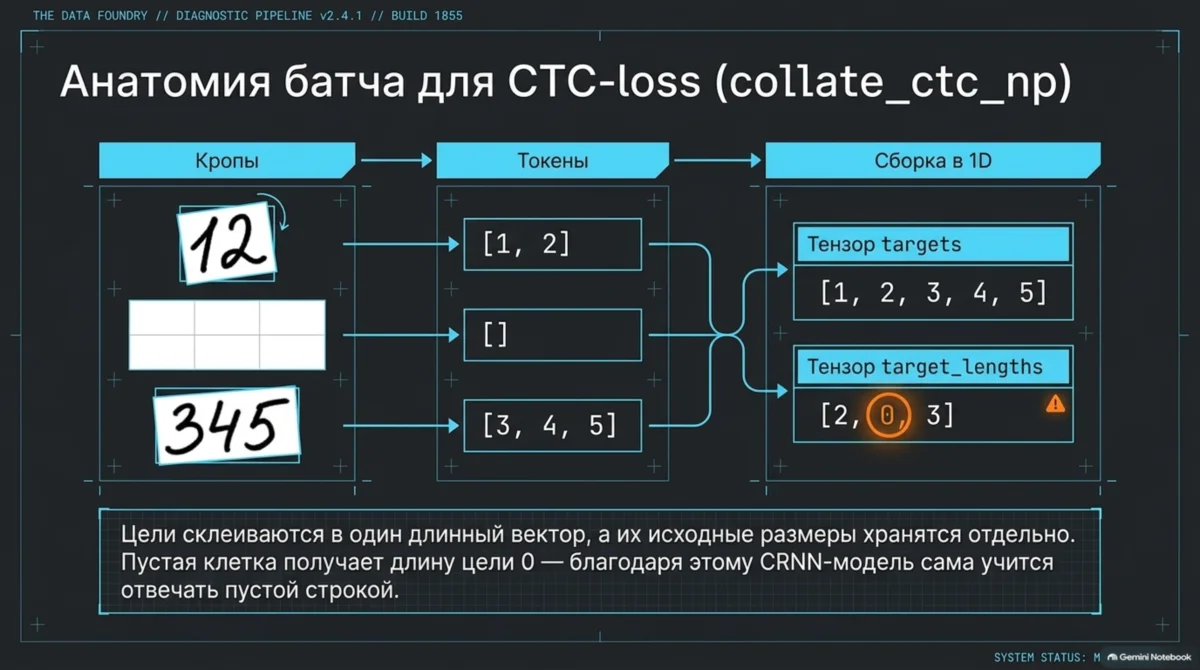
На рисунке индексы условные: строка «12» показана как [1, 2]. В алфавите measurement из урока 3 ноль занят пустым символом CTC (blank), символ «0» имеет индекс 1, поэтому «1» — это 2, а «2» — это 3. Строка «12» кодируется как [2, 3]. Длины на рисунке настоящие: два знака, пустая клетка, три знака.
Эпохой называют один полный проход по обучающему списку. В train 3480 кропов. За одну эпоху каждый из них открывают по одному разу, с первой строки файла до последней. Обучение повторяет такой проход много раз подряд. Номер эпохи говорит, который это проход по счёту: сначала 1, потом 2, потом 3. В этом уроке сеть ещё не учится. Номер всё равно записываем заранее: от него зависит, какую копию кропа нарисует аугментация.
Одна и та же тройка чисел даёт одну и ту же картинку. Поворот, сдвиг и шум выбираются случайно. Если генератор случайных чисел один на весь список, вид кропа зависит от того, кто запросил его первым. Два запуска тогда разойдутся. Поэтому для каждого кропа генератор создаётся заново, из трёх чисел, и сразу после кропа забывается. В тройке лежат зерно обучения (seed), номер эпохи и номер строки этого кропа в файле разметки.
Номер строки закреплён за кропом. Семнадцатая строка train.jsonl и сегодня, и при следующем запуске остаётся кропом 17. Два рабочих процесса просят этот кроп на эпохе 3 при одном и том же зерне. Оба получают одну картинку, даже если один обратился раньше другого.
Перед эпохой вызывается set_epoch. В тройке меняется только номер эпохи, поэтому у кропа 17 на эпохе 4 другая копия: иной наклон или другой шум. Запустите обучение ещё раз с тем же зерном. На эпохе 3 кроп 17 снова получит ту же копию, что и в прошлый раз. DataLoader может выдать кропы в другом порядке. На пиксели это не влияет. Генератор смотрит на номер строки. Место кропа в пачке в тройку не входит.
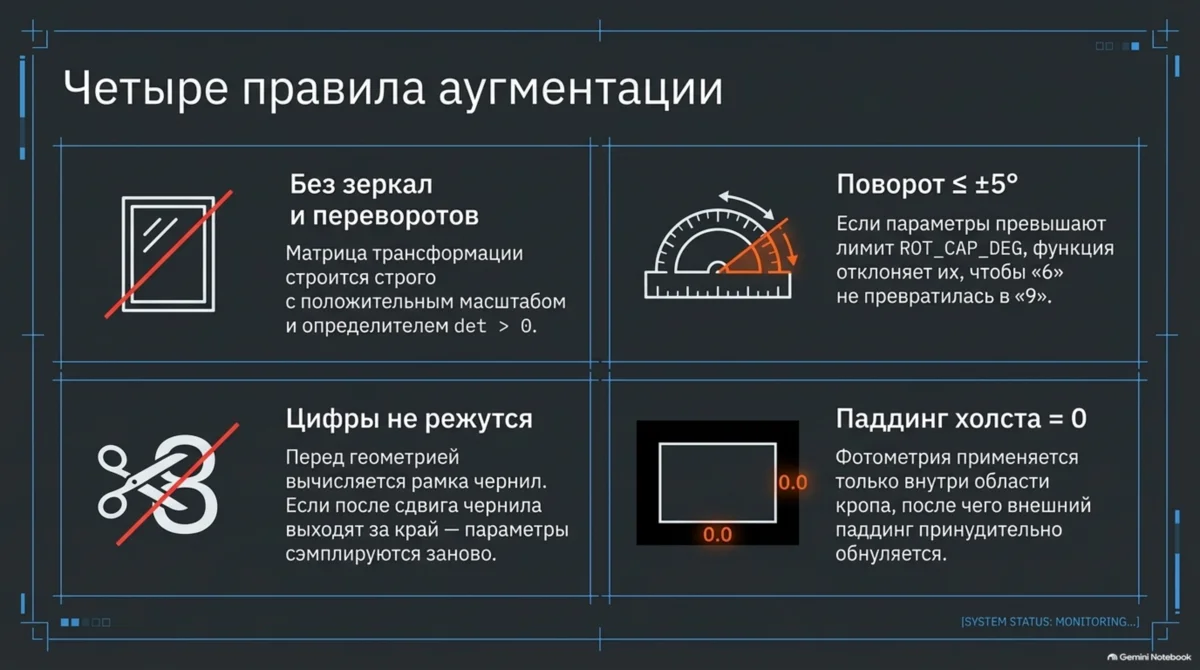
Четыре правила. Аугментация обязана сохранять метку. Код держит четыре запрета, и каждый закрыт тестом.
| Правило | Как гарантируется |
|---|---|
| Без зеркал и переворотов | Поворот, масштаб и сдвиг записаны одной матрицей чисел. Масштабы в ней только положительные, поэтому картинка не отражается. Зеркало слева направо поменяло бы края местами, и «12» читалось бы справа налево. Переворот сверху вниз перевернул бы цифру. Оба случая дают отрицательный определитель. Это одно число из матрицы, оно говорит об ориентации. Тест читает матрицу до пикселей и требует определитель больше нуля. Рядом он требует положительный горизонтальный масштаб: так отсекается поворот на пол-оборота. |
| Поворот не больше ±5° | Потолок записан в ROT_CAP_DEG и равен 5°. До рисования его проверяет validate_config. Угол больше потолка она отклоняет с ошибкой. При большем наклоне шестёрка уже похожа на девятку. В наборе DEFAULT поворот не больше ±3°, в PRINTED он доходит ровно до ±5°. |
| Цифры не режутся | Сначала обводится прямоугольник, внутри которого лежат чернила цифр. Потом считаются его четыре угла после сдвига. Угол за краем кропа значит, что знак обрежется. Такие параметры выбрасываются, и выбираются новые. Попыток восемь (GEOMETRY_TRIES). Если все восемь режут цифру, геометрия пропускается, и кроп остаётся как был. |
| Паддинг остаётся ровно 0 | Холст 48×160 больше кропа, и пустые поля вокруг него равны нулю. Бледность, размытие, JPEG и шум пишутся только внутри прямоугольника кропа. Поля после этого снова ставятся в 0. На val в этих полях шума нет, поэтому обучение не должно добавлять его туда. |
Тест на зеркало не сравнивает готовые картинки. Он читает ту же матрицу, которой потом рисуется кроп. Подмена, которая отражает картинку или ставит её вверх ногами, роняет тест сразу, ещё до пикселей.
Холст после урока 2 уже инвертирован: штрих светлый, фон чёрный. Кроп прижат к левому краю и отцентрирован по высоте. Справа обычно остаётся поле из нулей. Шум в это поле не пишется, иначе обучение и проверка смотрели бы на разный фон.
Сначала геометрия, потом контраст, потом шум. На исходном сером скане считаются поворот, масштаб, наклон и сдвиг. Затем обычный препроцессинг урока 2: контраст растягивается функцией autocontrast_safe, штрих становится единицей, фон нулём, кроп ложится на холст. Уже на готовом холсте чернила бледнеют, появляется размытие, иногда сжатие JPEG и гауссов шум.
Шаги стоят в этом порядке не случайно. Если зашумить бумагу до растяжения контраста, защита из урока 2 примет шум за чернила и нарисует текст на пустой клетке.
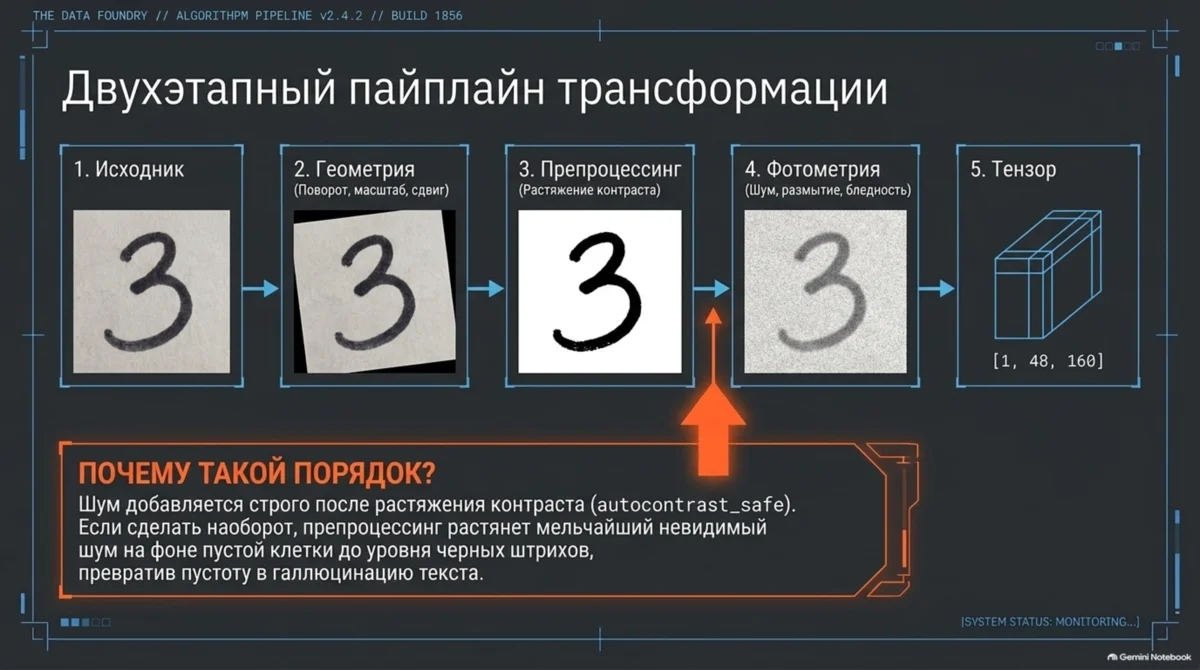
На схеме шаг «геометрия» нарисован уже на тёмном поле. В коде в этот момент картинка ещё серый скан. Чёрный фон появляется после preprocess_array.
Линия рамки не считается цифрой. Перед сдвигом код обводит чернила прямоугольником и смотрит, не выйдут ли его углы за край кропа. У клетки бланка есть своя линия рамки. Она идёт через весь кроп и уже упирается в край. Если оставить её внутри прямоугольника, один край прямоугольника лежит на границе картинки. Любой сдвиг или поворот вытолкнет эту линию наружу. Все восемь попыток будут отвергнуты, и геометрия не применится ни разу, хотя сами цифры сидят посередине и их можно подвинуть.
Поэтому такие линии из прямоугольника убирают. Берут строку или столбец, где тёмные пиксели занимают 85 % длины и больше. Это порог LINE_FRAC. Такая полоса считается линией рамки, а не штрихом цифры, и из маски чернил выбрасывается. Прямоугольник после этого обводит только цифры, и до края кропа остаётся запас. Тест сравнивает листы с рамкой и без неё. Геометрия срабатывает одинаково часто.
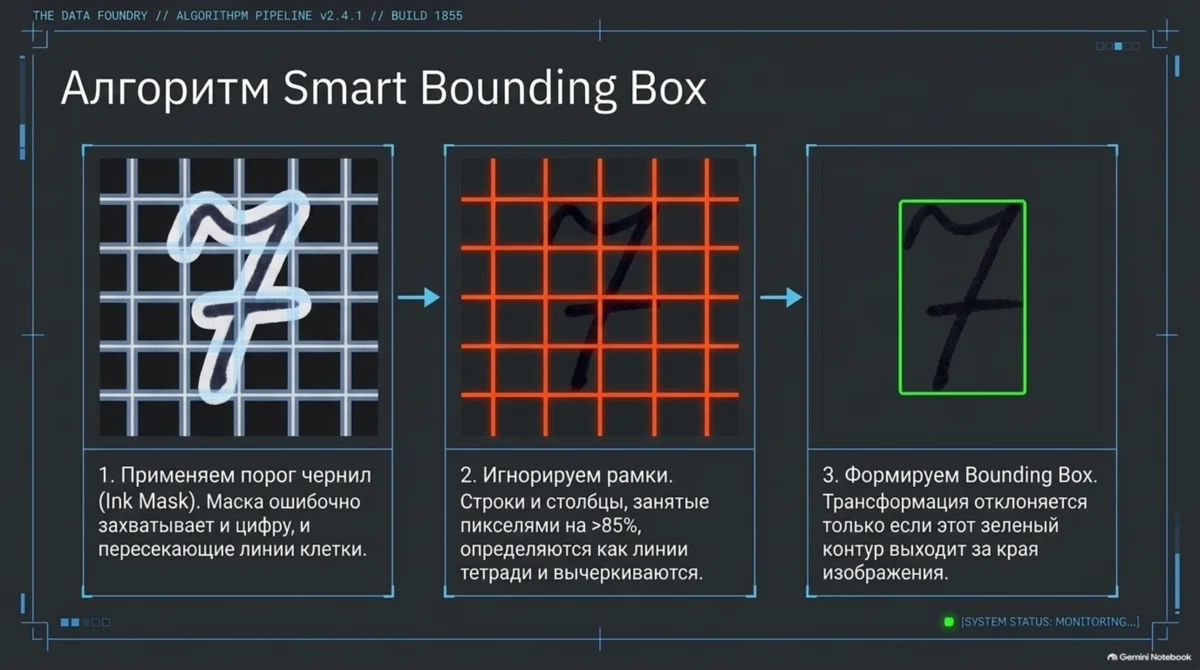
На рисунке эти линии названы клеткой тетради. На бланке это рамка клетки. Длинная прямая не должна попасть в прямоугольник цифр.
Два набора параметров. DEFAULT — лёгкие сдвиги «от руки». PRINTED — фото печати: чернила бледнее, размытие чаще, в половине случаев JPEG, шум сильнее. В обучении стиль выбирается явно. Оценку на отдельных фото кропах отложим до урока 15.
Наклон (shear) сдвигает верх кропа относительно низа, как курсив, и не переворачивает цифру. Пропорции (aspect) слегка вытягивают кроп по ширине или по высоте. В таблице на рисунке этих двух строк нет. Они есть в коде и в таблице ниже. На рисунке цветом выделены бледность и шум. Это самые заметные отличия PRINTED, не полный список.
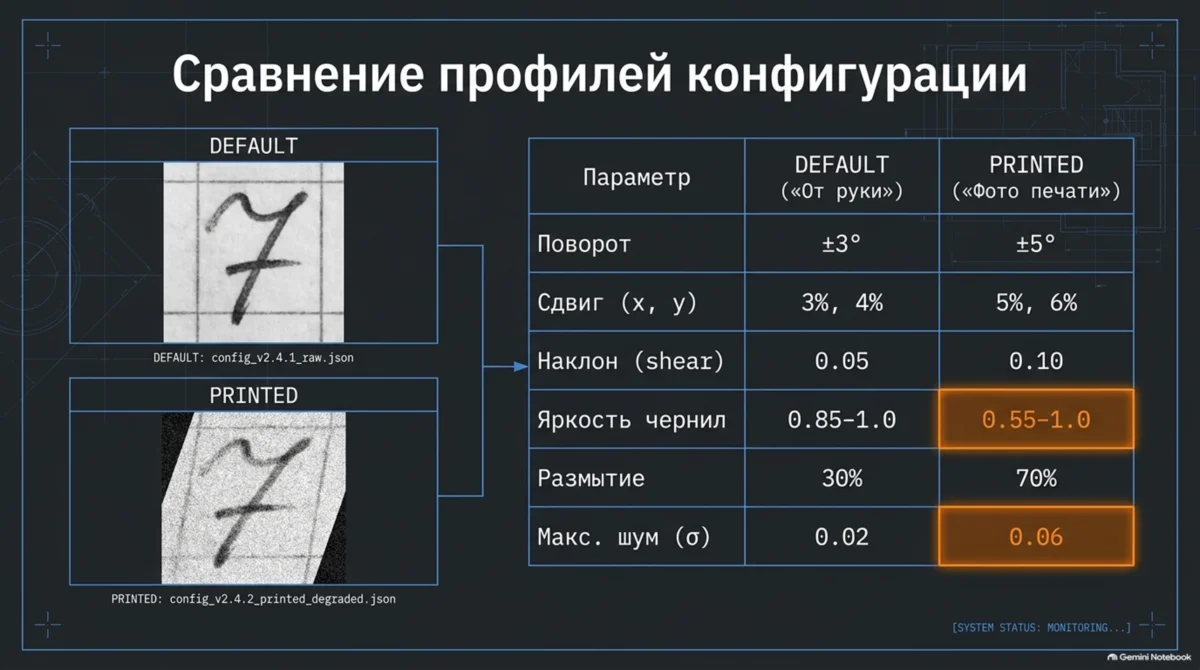
| Параметр | DEFAULT («от руки») |
PRINTED («фото печати») |
|---|---|---|
| поворот, ° | ±3 | ±5 |
| масштаб | 0.93–1.07 | 0.85–1.15 |
| пропорции | 0.96–1.04 | 0.90–1.10 |
| наклон | 0.05 | 0.10 |
| сдвиг (доли кропа) | 3 % по x, 4 % по y | 5 % по x, 6 % по y |
| яркость чернил | 0.85–1.0 | 0.55–1.0 |
| размытие | в 30 % случаев, радиус 0.4–0.9 | в 70 % случаев, радиус 0.5–1.4 |
| JPEG | нет | в 50 % случаев, качество 30–85 |
| шум (максимум σ) | 0.02 | 0.06 |
Напиши сам
Сначала положите файлы в свой репозиторий. Блоки ниже свёрнуты: разверните и скопируйте каждый файл целиком в указанный путь. Команды урока запускайте после этого, из корня репозитория.
В src/datasets/crop_dataset.py две части стоит прочитать до запуска. set_epoch только запоминает номер эпохи. __getitem__ при augment=None зовёт обычный preprocess_array, и кроп совпадает с тем, что модель увидит на val. Аугментация включается только когда вы её передали. Генератор собирается из зерна, эпохи и индекса, поэтому результат не зависит от числа рабочих процессов загрузчика.
Сборка батча для CTC склеивает цели в один вектор и хранит длины отдельно. Пустая клетка получает длину 0. Для детектора пустой клетки есть вторая функция, collate_classify_np: она кладёт в батч массив labels, где 1 значит «пусто». Обе функции остаются на NumPy. to_torch оборачивает массивы в тензоры, когда батч уже собран. collate_ctc и collate_classify — это to_torch поверх этих двух функций. Обе лежат в том же файле целиком.
Как это стыкуется с загрузчиком, видно по примеру ниже. В этом уроке его не запускают: обучение начнётся в уроке 7, а полный цикл по эпохам — ещё позже. python src/train_....py сам кладёт папку src в путь импорта. Если набрать фрагмент отдельным файлом в корне репозитория, импорт datasets не найдётся, пока вы не добавите src в PYTHONPATH.
import torch
from datasets.crop_dataset import CropDataset, collate_ctc
from augment import augment_default
from seed import make_generator, seed_worker

train = CropDataset("data/processed", "train", augment=augment_default, seed=0)
loader = torch.utils.data.DataLoader(
    train, batch_size=16, shuffle=True, collate_fn=collate_ctc,
    generator=make_generator(0), worker_init_fn=seed_worker)

for epoch in range(30):
    train.set_epoch(epoch)       # аугментация меняется от эпохи к эпохе
    for batch in loader:
        ...                      # batch["images"], batch["targets"], batch["target_lengths"]
Пакет датасета, одна строка (развернуть)
"""Датасеты курса."""Класс кропов и сборка батча, 92 строки (развернуть)
"""Dataset поверх train/val/test.jsonl (по split.json) и функции сборки батча.
DataLoader не требует наследования от torch.utils.data.Dataset: достаточно __len__ и __getitem__.
Поэтому сам Dataset и сборка батча на NumPy не зависят от PyTorch; в тензоры батч превращает
тонкая обёртка to_torch().
"""
import json
from pathlib import Path
import numpy as np
from PIL import Image
from alphabet import encode_text
from image_to_tensor import preprocess_array
from split_groups import read_jsonl
VALUE_CLASS = 0
EMPTY_CLASS = 1 # P(empty) в уроках 7–9 — это вероятность класса 1
class CropDataset:
"""Один сплит. augment: функция (PIL-образ, rng) -> массив [1, 48, 160] или None."""
def __init__(self, data_dir, split: str, augment=None, seed: int = 0) -> None:
data_dir = Path(data_dir)
manifest = json.loads((data_dir / "manifest.json").read_text(encoding="utf-8"))
self.task = manifest["task"]
self.image_root = Path(manifest["image_root"])
self.records = read_jsonl(data_dir / f"{split}.jsonl")
self.augment = augment
self.seed = seed
self.epoch = 0
def __len__(self) -> int:
return len(self.records)
def set_epoch(self, epoch: int) -> None:
"""Аугментация меняется от эпохи к эпохе, но воспроизводима."""
self.epoch = epoch
def __getitem__(self, i: int) -> dict:
rec = self.records[i]
path = self.image_root / rec["image"]
if self.augment is None:
image = preprocess_array(path)
else:
# у каждого (seed, эпоха, индекс) свой генератор: результат не зависит от воркеров DataLoader
rng = np.random.default_rng([self.seed, self.epoch, i])
img = Image.open(path)
img.load()
image = self.augment(img, rng)
return {
"id": rec["id"],
"image": image,
"text": rec["text"],
"target": np.array(encode_text(rec["text"], self.task), dtype=np.int64),
"label": EMPTY_CLASS if rec["is_empty"] else VALUE_CLASS,
"is_empty": bool(rec["is_empty"]),
}
def collate_ctc_np(batch: list[dict]) -> dict:
"""Батч для CTC: цели склеены в один вектор + длины целей (пустая клетка = длина 0)."""
return {
"images": np.stack([b["image"] for b in batch]).astype(np.float32),
"targets": np.concatenate([b["target"] for b in batch]).astype(np.int64),
"target_lengths": np.array([len(b["target"]) for b in batch], dtype=np.int64),
"texts": [b["text"] for b in batch],
"ids": [b["id"] for b in batch],
}
def collate_classify_np(batch: list[dict]) -> dict:
"""Батч для бинарной классификации empty / value."""
return {
"images": np.stack([b["image"] for b in batch]).astype(np.float32),
"labels": np.array([b["label"] for b in batch], dtype=np.int64),
"ids": [b["id"] for b in batch],
}
def to_torch(batch: dict) -> dict:
import torch # импорт здесь: всё остальное в файле не требует torch
return {k: torch.from_numpy(v) if isinstance(v, np.ndarray) else v for k, v in batch.items()}
def collate_ctc(batch: list[dict]) -> dict:
return to_torch(collate_ctc_np(batch))
def collate_classify(batch: list[dict]) -> dict:
return to_torch(collate_classify_np(batch))Аугментации, которые сохраняют метку, 181 строка (развернуть)
"""Аугментации, СОХРАНЯЮЩИЕ МЕТКУ.
Правила (их проверяют тесты):
* без зеркал и переворотов; поворот не больше ±5° (иначе 6 превращается в 9);
* геометрия не режет цифры: если после преобразования чернила вышли бы за край кропа,
преобразование отклоняется и пробуется заново;
* паддинг холста остаётся ровно 0 (как при проверке на val и в проде).
Аугментация идёт в два этапа:
1) геометрия на исходном кропе (поворот, масштаб, наклон, сдвиг);
2) фотометрия на готовом холсте 48×160 (бледность чернил, размытие, JPEG, шум):
шум добавляется ПОСЛЕ растяжения контраста, поэтому защита из урока 2 не нужна.
"""
import io
import math
from dataclasses import dataclass, replace
import numpy as np
from PIL import Image, ImageFilter
from image_to_tensor import CANVAS_H, CANVAS_W, load_image, preprocess_array, to_gray_on_white
ROT_CAP_DEG = 5.0 # больше нельзя: 6 и 9 начинают путаться
MIN_INK_CONTRAST = 25 # слабее — в кропе нет заметных чернил
INK_LEVEL = 0.35 # чернилами считаем пиксели темнее бумаги на 35 % контраста
LINE_FRAC = 0.85 # строка/столбец, занятые чернилами на 85 %+, — линия-рамка, а не цифры
GEOMETRY_TRIES = 8
@dataclass(frozen=True)
class AugmentConfig:
rot_deg: float = 3.0
scale: tuple = (0.93, 1.07)
aspect: tuple = (0.96, 1.04)
shear: float = 0.05
shift_x: float = 0.03 # доли ширины кропа
shift_y: float = 0.04 # доли высоты кропа
gain: tuple = (0.85, 1.0) # множитель яркости чернил (меньше = бледнее)
blur_prob: float = 0.3
blur_radius: tuple = (0.4, 0.9)
jpeg_prob: float = 0.0
jpeg_quality: tuple = (60, 95)
noise: float = 0.02 # максимум σ гауссова шума (в долях 0..1)
DEFAULT = AugmentConfig()
PRINTED = AugmentConfig(rot_deg=5.0, scale=(0.85, 1.15), aspect=(0.90, 1.10), shear=0.10,
shift_x=0.05, shift_y=0.06, gain=(0.55, 1.0), blur_prob=0.7,
blur_radius=(0.5, 1.4), jpeg_prob=0.5, jpeg_quality=(30, 85), noise=0.06)
def validate_config(cfg: AugmentConfig) -> None:
if abs(cfg.rot_deg) > ROT_CAP_DEG:
raise ValueError(f"rot_deg={cfg.rot_deg}: поворот больше ±{ROT_CAP_DEG}° не сохраняет метку")
def content_box(w0: int, h0: int, h: int = CANVAS_H, w: int = CANVAS_W) -> tuple[int, int, int, int]:
"""Где на холсте лежит кроп размера w0×h0 после letterbox: (x0, y0, x1, y1)."""
scale = min(w / w0, h / h0)
new_w = max(1, round(w0 * scale))
new_h = max(1, round(h0 * scale))
top = (h - new_h) // 2
return 0, top, new_w, top + new_h
def ink_mask(gray: np.ndarray) -> np.ndarray | None:
"""Маска «цифр» на исходном кропе (без линий-рамок); None, если чернил нет."""
g = gray.astype(np.float32)
paper = float(np.median(g))
contrast = paper - float(g.min())
if contrast < MIN_INK_CONTRAST:
return None
mask = (paper - g) > INK_LEVEL * contrast
rows_full = mask.mean(axis=1) > LINE_FRAC
cols_full = mask.mean(axis=0) > LINE_FRAC
mask[rows_full, :] = False
mask[:, cols_full] = False
return mask if mask.any() else None
def ink_bbox(gray: np.ndarray):
"""(x0, y0, x1, y1) рамка чернил (x1, y1 не включены) или None."""
mask = ink_mask(gray)
if mask is None:
return None
ys, xs = np.where(mask)
return int(xs.min()), int(ys.min()), int(xs.max()) + 1, int(ys.max()) + 1
def _translation(tx: float, ty: float) -> np.ndarray:
return np.array([[1, 0, tx], [0, 1, ty], [0, 0, 1]], dtype=np.float64)
def affine_forward(w: int, h: int, rot_deg: float, sx: float, sy: float,
shear: float, tx: float, ty: float) -> np.ndarray:
"""Матрица 3×3: поворот, наклон и масштаб вокруг центра кропа, затем сдвиг."""
th = math.radians(rot_deg)
rot = np.array([[math.cos(th), -math.sin(th), 0], [math.sin(th), math.cos(th), 0], [0, 0, 1]])
sh = np.array([[1, shear, 0], [0, 1, 0], [0, 0, 1]], dtype=np.float64)
sc = np.diag([sx, sy, 1.0])
return _translation(w / 2 + tx, h / 2 + ty) @ rot @ sh @ sc @ _translation(-w / 2, -h / 2)
def sample_matrix(w: int, h: int, rng: np.random.Generator, cfg: AugmentConfig) -> np.ndarray:
"""Случайное преобразование кропа w×h. Масштабы положительные, поворот ≤ rot_deg: отражений не бывает."""
rot = float(rng.uniform(-cfg.rot_deg, cfg.rot_deg))
s = float(rng.uniform(*cfg.scale))
a = float(rng.uniform(*cfg.aspect))
shear = float(rng.uniform(-cfg.shear, cfg.shear))
tx = float(rng.uniform(-cfg.shift_x, cfg.shift_x)) * w
ty = float(rng.uniform(-cfg.shift_y, cfg.shift_y)) * h
return affine_forward(w, h, rot, s * math.sqrt(a), s / math.sqrt(a), shear, tx, ty)
def geometric(img: Image.Image, rng: np.random.Generator, cfg: AugmentConfig) -> tuple[Image.Image, bool]:
"""Геометрия на исходном кропе. Возвращает (картинка, применилась ли геометрия)."""
gray = to_gray_on_white(img)
w, h = gray.size
arr = np.asarray(gray)
bbox = ink_bbox(arr)
paper = int(np.median(arr))
for _ in range(GEOMETRY_TRIES):
m = sample_matrix(w, h, rng, cfg)
if bbox is not None:
x0, y0, x1, y1 = bbox
corners = m @ np.array([[x0, x1, x1, x0], [y0, y0, y1, y1], [1, 1, 1, 1]], dtype=np.float64)
if (corners[0].min() < 1 or corners[0].max() > w - 1
or corners[1].min() < 1 or corners[1].max() > h - 1):
continue # цифры вышли бы за край: пробуем другие параметры
inv = np.linalg.inv(m)
coeffs = (inv[0, 0], inv[0, 1], inv[0, 2], inv[1, 0], inv[1, 1], inv[1, 2])
out = gray.transform((w, h), Image.Transform.AFFINE, coeffs,
resample=Image.Resampling.BILINEAR, fillcolor=paper)
return out, True
return gray, False
def photometric(arr: np.ndarray, box: tuple, rng: np.random.Generator, cfg: AugmentConfig) -> np.ndarray:
"""Фотометрия на холсте [1, 48, 160]; паддинг в конце снова обнуляется."""
a = arr[0].copy()
x0, y0, x1, y1 = box
a[y0:y1, x0:x1] *= float(rng.uniform(*cfg.gain))
if rng.random() < cfg.blur_prob:
im = Image.fromarray((a * 255).round().astype(np.uint8), mode="L")
a = np.asarray(im.filter(ImageFilter.GaussianBlur(float(rng.uniform(*cfg.blur_radius)))),
dtype=np.float32) / 255.0
if rng.random() < cfg.jpeg_prob:
buf = io.BytesIO()
Image.fromarray((a * 255).round().astype(np.uint8), mode="L").save(
buf, "JPEG", quality=int(rng.integers(cfg.jpeg_quality[0], cfg.jpeg_quality[1] + 1)))
buf.seek(0)
a = np.asarray(Image.open(buf).convert("L"), dtype=np.float32) / 255.0
sigma = float(rng.uniform(0.0, cfg.noise))
if sigma > 0:
a = a + rng.normal(0.0, sigma, size=a.shape).astype(np.float32)
a = np.clip(a, 0.0, 1.0)
keep = np.zeros(a.shape, dtype=bool)
keep[y0:y1, x0:x1] = True
a[~keep] = 0.0 # паддинг остаётся ровно 0
return a[None, :, :].astype(np.float32)
def augment(source, rng: np.random.Generator, cfg: AugmentConfig, validate: bool = True) -> np.ndarray:
"""Путь или PIL-образ → аугментированный массив [1, 48, 160]."""
if validate:
validate_config(cfg)
img, _ = geometric(load_image(source), rng, cfg)
arr = preprocess_array(img)
return photometric(arr, content_box(*img.size), rng, cfg)
def augment_default(source, rng: np.random.Generator) -> np.ndarray:
return augment(source, rng, DEFAULT)
def augment_printed(source, rng: np.random.Generator) -> np.ndarray:
return augment(source, rng, PRINTED)
def with_overrides(cfg: AugmentConfig, **kwargs) -> AugmentConfig:
return replace(cfg, **kwargs)Сетка 4 на 4, 79 строк (развернуть)
"""Сетка 4×4: исходный кроп и 15 его аугментаций."""
import argparse
import json
import sys
from pathlib import Path
import matplotlib
import numpy as np
matplotlib.use("Agg")
import matplotlib.pyplot as plt # noqa: E402
sys.path.insert(0, str(Path(__file__).resolve().parents[1] / "src"))
from augment import DEFAULT, PRINTED, augment, validate_config, with_overrides # noqa: E402
from image_to_tensor import load_image, preprocess_array # noqa: E402
def parse_overrides(items: list[str]) -> dict:
out = {}
for item in items:
key, _, value = item.partition("=")
out[key] = float(value)
return out
def main() -> None:
ap = argparse.ArgumentParser()
ap.add_argument("--image", help="путь к кропу")
ap.add_argument("--find-text", help="взять первый кроп из train.jsonl с такой меткой, например 6")
ap.add_argument("--data-dir", default="data/processed")
ap.add_argument("--style", choices=["default", "printed"], default="default")
ap.add_argument("--override", action="append", default=[], metavar="ключ=значение",
help="переопределить параметр, например rot_deg=40 или noise=0.1")
ap.add_argument("--unsafe", action="store_true", help="не проверять правило «поворот ≤ 5°»")
ap.add_argument("--seed", type=int, default=0)
ap.add_argument("--out", default="experiments/aug_grid.png")
args = ap.parse_args()
if args.find_text:
data_dir = Path(args.data_dir)
manifest = json.loads((data_dir / "manifest.json").read_text(encoding="utf-8"))
with open(data_dir / "train.jsonl", encoding="utf-8") as f:
rec = next((r for r in map(json.loads, f) if r["text"] == args.find_text), None)
if rec is None:
sys.exit(f"В {data_dir / 'train.jsonl'} нет кропа с меткой {args.find_text!r}: попробуйте другую метку.")
image_path = Path(manifest["image_root"]) / rec["image"]
elif args.image:
image_path = Path(args.image)
else:
sys.exit("Укажите --image или --find-text")
cfg = with_overrides(DEFAULT if args.style == "default" else PRINTED, **parse_overrides(args.override))
img = load_image(image_path)
rng = np.random.default_rng(args.seed)
try:
validate_config(cfg)
except ValueError as e:
if not args.unsafe:
sys.exit(f"Параметры отклонены: {e}.\nДля эксперимента добавьте --unsafe (в обучении так делать нельзя).")
fig, axes = plt.subplots(4, 4, figsize=(10, 4.2))
for k, ax in enumerate(axes.flat):
arr = preprocess_array(img) if k == 0 else augment(img, rng, cfg, validate=False)
ax.imshow(arr[0], cmap="gray", vmin=0, vmax=1)
ax.set_title("исходный" if k == 0 else f"#{k}", fontsize=7)
ax.set_xticks([])
ax.set_yticks([])
extra = f" {' '.join(args.override)}" if args.override else ""
fig.suptitle(f"{image_path.name}: стиль {args.style}{extra}", fontsize=9)
fig.tight_layout()
out = Path(args.out)
out.parent.mkdir(parents=True, exist_ok=True)
fig.savefig(out, dpi=110)
print(f"сохранено: {out}")
if __name__ == "__main__":
main()Тесты аугментаций, 184 строки (развернуть)
import sys
from dataclasses import replace
from pathlib import Path
import numpy as np
import pytest
from PIL import Image
sys.path.insert(0, str(Path(__file__).resolve().parents[1] / "src"))
from augment import ( # noqa: E402
DEFAULT, PRINTED, ROT_CAP_DEG, augment, content_box, geometric, ink_bbox, ink_mask, sample_matrix,
validate_config,
)
from image_to_tensor import CANVAS_H, CANVAS_W, preprocess_array, to_gray_on_white # noqa: E402
from make_synthetic_crops import generate # noqa: E402
import json # noqa: E402
import math # noqa: E402
import tempfile # noqa: E402
_cache: dict = {}
_tmp: list = []
def sample_crops() -> list:
"""Value-кропы двух листов (один с рамкой, другой без): (PIL-образ, метка)."""
if "crops" not in _cache:
d = tempfile.TemporaryDirectory()
_tmp.append(d)
generate(d.name, sheets=8, per_sheet=10, seed=11)
styles = json.loads((Path(d.name) / "sheets.json").read_text(encoding="utf-8"))
crops = []
for line in open(Path(d.name) / "index.jsonl", encoding="utf-8"):
r = json.loads(line)
if r["kind"] == "value":
img = Image.open(Path(d.name) / r["file"])
img.load()
crops.append((img, r["text"], styles[r["sheet"]]["border"]))
_cache["crops"] = crops
return _cache["crops"]
def text_like(w: int, h: int) -> Image.Image:
img = Image.new("L", (w, h), 235)
img.paste(40, (w // 5, h // 4, w // 2, 3 * h // 4))
img.paste(40, (w // 2 + 4, h // 4, 7 * w // 10, 3 * h // 4))
return img
def test_content_box_matches_letterbox():
for w0, h0 in [(40, 50), (100, 40), (200, 50), (380, 70), (160, 48), (30, 30)]:
dark = preprocess_array(Image.new("L", (w0, h0), 0))[0] # однородно тёмный → единицы только в содержимом
x0, y0, x1, y1 = content_box(w0, h0)
expected = np.zeros((CANVAS_H, CANVAS_W), dtype=bool)
expected[y0:y1, x0:x1] = True
assert ((dark > 0.5) == expected).all(), (w0, h0)
def test_shape_dtype_range_for_both_styles():
for cfg in (DEFAULT, PRINTED):
arr = augment(text_like(120, 40), np.random.default_rng(0), cfg)
assert arr.shape == (1, CANVAS_H, CANVAS_W)
assert arr.dtype == np.float32
assert arr.min() >= 0.0 and arr.max() <= 1.0
def test_deterministic_for_same_rng_and_different_for_other():
img = text_like(120, 40)
a = augment(img, np.random.default_rng([1, 2, 3]), PRINTED)
b = augment(img, np.random.default_rng([1, 2, 3]), PRINTED)
c = augment(img, np.random.default_rng([1, 2, 4]), PRINTED)
assert (a == b).all()
assert not (a == c).all()
def test_padding_stays_exactly_zero():
img = text_like(40, 50) # узкий кроп: справа много паддинга
x0, y0, x1, y1 = content_box(40, 50)
for seed in range(20):
arr = augment(img, np.random.default_rng(seed), PRINTED)[0]
assert np.all(arr[:, x1:] == 0.0)
assert np.all(arr[:y0, :] == 0.0) and np.all(arr[y1:, :] == 0.0)
def test_geometry_never_cuts_digits():
# Рамку клетки после поворота нельзя отличить от чернил, поэтому границы проверяем на листах без рамки;
# потерю чернил (резать цифры нельзя) проверяем на всех.
checked_bbox = checked_mass = 0
for img, text, border in sample_crops():
gray = np.asarray(to_gray_on_white(img))
before = ink_mask(gray)
for seed in range(15):
out, applied = geometric(img, np.random.default_rng(seed), PRINTED)
if not applied:
continue
out_gray = np.asarray(out)
assert ink_mask(out_gray).sum() >= 0.6 * before.sum(), text
checked_mass += 1
if border:
continue
after = ink_bbox(out_gray)
h, w = out_gray.shape
assert after is not None, text
assert after[0] >= 1 and after[1] >= 1 and after[2] <= w - 1 and after[3] <= h - 1, (text, after)
checked_bbox += 1
assert checked_mass > 200 and checked_bbox > 80, (checked_mass, checked_bbox)
def test_borders_do_not_disable_geometry():
# Линия-рамка клетки не должна считаться «цифрами»: иначе на листах с рамкой геометрия не применялась бы.
applied = {True: 0, False: 0}
total = {True: 0, False: 0}
for img, text, border in sample_crops():
for seed in range(5):
_, ok = geometric(img, np.random.default_rng(seed), PRINTED)
applied[border] += ok
total[border] += 1
for border in (True, False):
assert total[border] > 0
assert applied[border] / total[border] > 0.8, (border, applied[border] / total[border])
def test_rotation_cap():
validate_config(DEFAULT)
validate_config(PRINTED)
with pytest.raises(ValueError):
validate_config(replace(DEFAULT, rot_deg=ROT_CAP_DEG + 1))
with pytest.raises(ValueError):
augment(text_like(100, 40), np.random.default_rng(0), replace(DEFAULT, rot_deg=30))
augment(text_like(100, 40), np.random.default_rng(0), replace(DEFAULT, rot_deg=30), validate=False)
def pooled(a: np.ndarray) -> np.ndarray:
return a.reshape(CANVAS_H // 2, 2, CANVAS_W // 2, 2).mean(axis=(1, 3))
def best_corr(a: np.ndarray, b: np.ndarray) -> float:
"""Лучшая корреляция по небольшим сдвигам: устойчива к сдвигу текста, чувствительна к зеркалу."""
a, b = pooled(a), pooled(b)
best = -1.0
for dy in range(-3, 4):
for dx in range(-5, 6):
shifted = np.roll(np.roll(b, dy, axis=0), dx, axis=1)
best = max(best, float(np.corrcoef(a.ravel(), shifted.ravel())[0, 1]))
return best
def test_transform_is_never_a_reflection_and_respects_rotation_cap():
# Переворот по вертикали по корреляции не проверить (цифры почти симметричны), поэтому проверяем матрицу:
# определитель > 0 и положительный масштаб по x исключают отражения, угол ограничен.
for cfg in (DEFAULT, PRINTED):
rng = np.random.default_rng(0)
for _ in range(2000):
m = sample_matrix(160, 48, rng, cfg)
assert np.linalg.det(m[:2, :2]) > 0
assert m[0, 0] > 0
assert abs(math.degrees(math.atan2(m[1, 0], m[0, 0]))) <= min(cfg.rot_deg, ROT_CAP_DEG) + 1e-9
def test_no_horizontal_mirror():
# Аугментированный кроп (с поправкой на сдвиг) в среднем похож на исходный сильнее, чем на его зеркало.
# Почти симметричные кропы пропускаем: у них зеркало ≈ оригинал.
checked = 0
for img, text, _ in sample_crops()[:30]:
clean = preprocess_array(img)[0]
if clean.std() < 1e-3:
continue
mirrored = np.ascontiguousarray(clean[:, ::-1])
if best_corr(clean, mirrored) > 0.5:
continue
augs = [augment(img, np.random.default_rng(seed), PRINTED)[0] for seed in range(5)]
same = np.mean([best_corr(a, clean) for a in augs])
other = np.mean([best_corr(a, mirrored) for a in augs])
assert same > other, (text, same, other)
checked += 1
assert checked >= 10, checked
def test_printed_is_stronger_than_default():
img = text_like(150, 45)
clean = preprocess_array(img)[0]
def mean_change(cfg):
return np.mean([np.abs(augment(img, np.random.default_rng(s), cfg)[0] - clean).mean() for s in range(60)])
assert mean_change(PRINTED) > 1.5 * mean_change(DEFAULT)Тесты набора данных, 128 строк (развернуть)
import subprocess
import sys
import tempfile
from pathlib import Path
import numpy as np
import pytest
from PIL import Image
ROOT = Path(__file__).resolve().parents[1]
sys.path.insert(0, str(ROOT / "src"))
from alphabet import decode_indices # noqa: E402
from augment import augment_default, augment_printed, content_box # noqa: E402
from datasets.crop_dataset import ( # noqa: E402
EMPTY_CLASS, VALUE_CLASS, CropDataset, collate_classify_np, collate_ctc_np,
)
from image_to_tensor import preprocess_array # noqa: E402
_cache: dict = {}
_tmp: list = []
def run(*args) -> None:
subprocess.run([sys.executable, *map(str, args)], cwd=ROOT, check=True, capture_output=True)
def data_dir() -> Path:
"""Маленький датасет (16 листов × 10 кропов), собранный теми же командами, что в уроках 4–5."""
if "dir" not in _cache:
d = tempfile.TemporaryDirectory()
_tmp.append(d)
base = Path(d.name)
run("src/make_synthetic_crops.py", "--out", base / "syn", "--sheets", 16, "--per-sheet", 10, "--seed", 3)
run("src/prepare_dataset.py", "--source", "synthetic", "--src", base / "syn", "--out", base / "proc")
run("src/split_groups.py", "--src", base / "proc", "--out", base / "proc")
_cache["dir"] = base / "proc"
return _cache["dir"]
def test_lengths_match_split_files():
d = data_dir()
for split in ("train", "val", "test"):
n_lines = sum(1 for _ in open(d / f"{split}.jsonl", encoding="utf-8"))
assert len(CropDataset(d, split)) == n_lines
def test_no_group_overlap_through_dataset():
d = data_dir()
groups = {s: {r["group_id"] for r in CropDataset(d, s).records} for s in ("train", "val", "test")}
assert groups["train"].isdisjoint(groups["val"])
assert groups["train"].isdisjoint(groups["test"])
assert groups["val"].isdisjoint(groups["test"])
def test_item_fields_and_shapes():
ds = CropDataset(data_dir(), "train")
for i in range(min(10, len(ds))):
item = ds[i]
assert item["image"].shape == (1, 48, 160) and item["image"].dtype == np.float32
assert item["target"].dtype == np.int64
assert decode_indices(item["target"].tolist(), ds.task) == item["text"]
assert item["label"] == (EMPTY_CLASS if item["is_empty"] else VALUE_CLASS)
assert item["is_empty"] == (item["text"] == "")
def test_without_augment_equals_plain_preprocess():
ds = CropDataset(data_dir(), "val")
rec = ds.records[0]
assert (ds[0]["image"] == preprocess_array(ds.image_root / rec["image"])).all()
def test_augmentation_is_reproducible_and_changes_with_epoch():
d = data_dir()
a = CropDataset(d, "train", augment=augment_printed, seed=5)
b = CropDataset(d, "train", augment=augment_printed, seed=5)
assert (a[3]["image"] == b[3]["image"]).all() # тот же seed, эпоха, индекс
first = a[3]["image"].copy()
a.set_epoch(1)
assert not (a[3]["image"] == first).all() # другая эпоха — другая аугментация
c = CropDataset(d, "train", augment=augment_printed, seed=6)
assert not (c[3]["image"] == first).all() # другой seed
def test_augmented_padding_is_zero_and_label_unchanged():
d = data_dir()
ds = CropDataset(d, "train", augment=augment_default, seed=0)
plain = CropDataset(d, "train")
for i in range(20):
assert ds[i]["text"] == plain[i]["text"]
assert ds[i]["target"].tolist() == plain[i]["target"].tolist()
with Image.open(ds.image_root / ds.records[i]["image"]) as raw:
x0, y0, x1, y1 = content_box(*raw.size)
image = ds[i]["image"][0]
assert np.all(image[:, x1:] == 0.0) and np.all(image[:y0, :] == 0.0) and np.all(image[y1:, :] == 0.0)
def test_collate_ctc_np():
ds = CropDataset(data_dir(), "train")
batch = [ds[i] for i in range(12)]
out = collate_ctc_np(batch)
assert out["images"].shape == (12, 1, 48, 160)
assert out["targets"].dtype == np.int64
assert out["target_lengths"].sum() == len(out["targets"])
for b, length in zip(batch, out["target_lengths"]):
assert length == len(b["text"])
assert any(length == 0 for length in out["target_lengths"]), "в батче нет пустых клеток"
def test_collate_classify_np():
ds = CropDataset(data_dir(), "train")
batch = [ds[i] for i in range(12)]
out = collate_classify_np(batch)
assert out["labels"].tolist() == [int(b["is_empty"]) for b in batch]
assert out["images"].shape == (12, 1, 48, 160)
def test_torch_collate_and_dataloader():
torch = pytest.importorskip("torch")
from datasets.crop_dataset import collate_ctc
from seed import make_generator, seed_worker
ds = CropDataset(data_dir(), "train", augment=augment_default, seed=0)
loader = torch.utils.data.DataLoader(ds, batch_size=8, shuffle=True, collate_fn=collate_ctc,
generator=make_generator(0), worker_init_fn=seed_worker)
batch = next(iter(loader))
assert tuple(batch["images"].shape) == (8, 1, 48, 160)
assert batch["images"].dtype == torch.float32
assert batch["targets"].dtype == torch.int64
assert int(batch["target_lengths"].sum()) == len(batch["targets"])Команды
Нужны data/processed и train.jsonl из уроков 4–5. Тесты Dataset маленький набор собирают сами, во временной папке. Сетки строятся на демо-кропах урока 2. Первая команда нужна, только если вы её там не запускали.
python src/make_demo_crops.py --out data/synthetic/raw
python experiments/show_augment_grid.py --image data/synthetic/raw/sample_7_3.png --style default --out experiments/aug_default.png
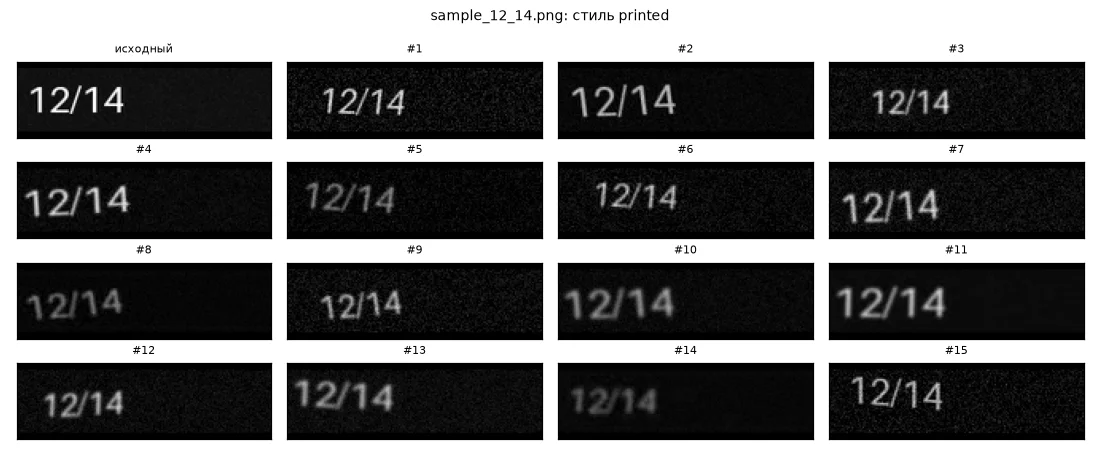
python experiments/show_augment_grid.py --image data/synthetic/raw/sample_12_14.png --style printed --out experiments/aug_printed.png
python -m pytest tests/test_augment.py tests/test_dataset.py -q
Скрипт сетки сам добавляет src в путь импорта. Запускайте его из корня репозитория.
Ожидаемое
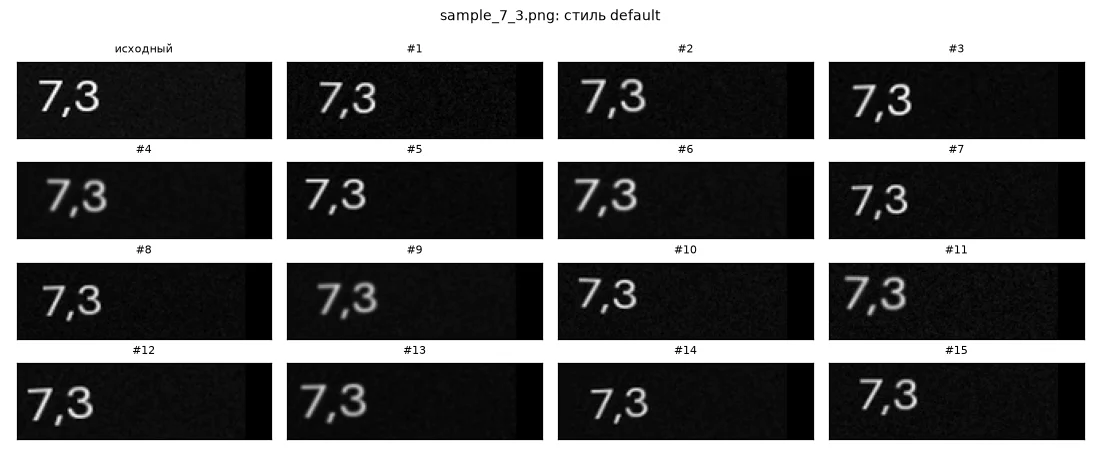
Две сетки. Первая клетка каждой — исходный кроп после препроцессинга, остальные пятнадцать — его аугментации. На теге lesson-06 команды печатают:
сохранено: experiments/aug_default.png
сохранено: experiments/aug_printed.png
...................                                                      [100%]
19 passed in 11.52s
Время pytest зависит от машины. Счётчик 19 passed — нет. Если PyTorch не установлен, тест загрузчика будет skipped, и вы увидите 18 passed, 1 skipped. Остальной урок torch не требует.
default на кропе sample_7_3.png: мягкие сдвиги, лёгкое размытие, чуть бледнее чернила. Цифры целиком внутри кропа. Справа остаётся чёрное поле. Это паддинг холста, его аугментация не закрашивает.
printed на кропе sample_12_14.png: бледные чернила, размытие, шум, наклон, большие сдвиги. Отдельные клетки совсем бледные. Строка по-прежнему читается.
Один проход по train, 3480 кропов, один процесс, этот ноутбук. Два замера подряд:
| Режим | Скорость | Один проход |
|---|---|---|
| без аугментации | ≈ 1800–2300 кропов/с | ≈ 1.5–2 с |
default |
≈ 980 кропов/с | ≈ 3.5 с |
printed |
≈ 950–1030 кропов/с | ≈ 3.4–3.7 с |
Проход занимает несколько секунд. Загрузка данных на этом размере не станет узким местом обучения.
Доля кропов, у которых геометрия применилась, на первых 1200 строках train: у заполненных клеток 100 % (default) и 99.9 % (printed); у пустых 75 % и 81 %. У пустой клетки нет цифры, которую можно отрезать. У штриховки и линий чернила занимают почти весь кроп, поэтому проверка границ отклоняет часть преобразований. Метку это не портит: у пустой клетки метка и так пустая.
Сравните с прогнозами.
- Метка не сохранится. На сетке ниже часть шестёрок становится девятками.
- Проход занимает секунды. Без аугментации ближе к двум, со стилем
printedоколо трёх с половиной. До половины минуты далеко. - Одинаково при тех же зерне, эпохе и индексе. Иначе по-другому. Это проверяет тест
test_augmentation_is_reproducible_and_changes_with_epoch.
Заметка про тесты: тест, который проверял вхолостую
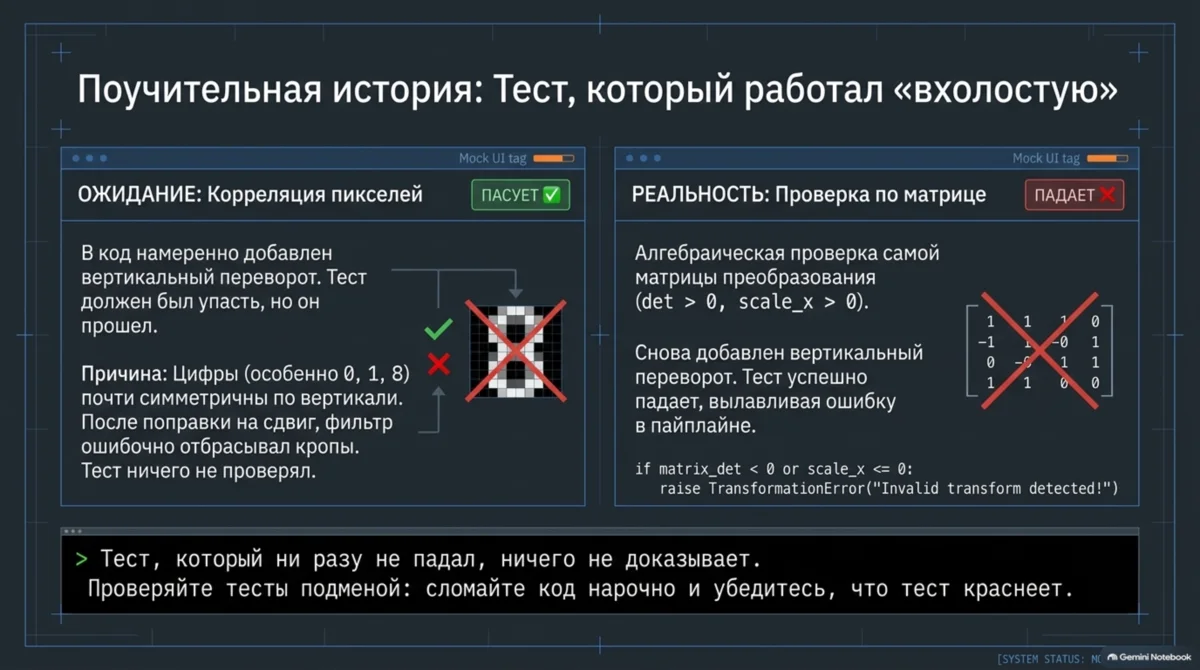
Сначала запрет переворотов проверяли по картинке. Аугментированный кроп должен быть похож на исходный сильнее, чем на зеркало или на копию, перевёрнутую сверху вниз. Сходство считали с поправкой на сдвиг: одну картинку двигали на несколько пикселей и брали лучшую корреляцию, чтобы честный сдвиг текста не выглядел как другая цифра. Тест был зелёным.
Потом аугментацию подменили на переворот сверху вниз. Тест остался зелёным. Цифры почти симметричны по вертикали. После сдвига перевёрнутая копия была так похожа на исходник, что фильтр выбрасывал почти все кропы, и до проверки дело не доходило. Тест ничего не стерег.
Сейчас переворот сверху вниз ловится по матрице, до пикселей. Определитель линейной части больше нуля, масштаб по горизонтали больше нуля, угол не больше лимита. Корреляция осталась только для зеркала слева направо. Почти симметричные кропы этот тест пропускает сознательно: у них зеркало неотличимо от оригинала. Подмена на переворот, на отражение в матрице и на поворот в 20° роняет тест.
На рисунке справа написан вымышленный TransformationError. В репозитории такого исключения нет. Падение теста — обычный assert в test_transform_is_never_a_reflection_and_respects_rotation_cap. На левой панели для примера нарисованы 0, 1 и 8. В коде отбор шире: пропускается любой кроп, у которого зеркало и так похоже на оригинал.
Тест, который ни разу не падал, ничего не доказывает. Сломайте код нарочно и убедитесь, что тест краснеет.
Упражнение (эксперимент)
Усиливайте augment_default, пока метка не перестанет сохраняться, и найдите границу по сетке. Параметры задаются из командной строки, код править не нужно. Флаг --unsafe отключает проверку «поворот не больше 5°». Только для этого эксперимента. В обучении флаг не используют.
Без флага скрипт отказывается:
python experiments/show_augment_grid.py --find-text 6 --style default --override rot_deg=30Параметры отклонены: rot_deg=30.0: поворот больше ±5.0° не сохраняет метку.
Для эксперимента добавьте --unsafe (в обучении так делать нельзя).Теперь с флагом. --find-text 6 берёт первый кроп с меткой 6 из train.jsonl. На данных урока 4 это images/sheet_0014/015.png, поэтому в заголовке сетки будет 015.png.
python experiments/show_augment_grid.py --find-text 6 --style default --unsafe \
  --override rot_deg=10 --out experiments/aug_rot10.png
python experiments/show_augment_grid.py --find-text 6 --style default --unsafe \
  --override rot_deg=180 --override shift_x=0 --override shift_y=0 \
  --out experiments/aug_rot180.png
сохранено: experiments/aug_rot180.pngПробуйте rot_deg 10, 30, 90, 180 и запишите, при каком угле «6» начинает напоминать «9». На rot_deg=180 девятками стали клетки #5, #7 и #12. Цифра при этом уехала вправо. Косая черта на этих клетках — рамка клетки: она поворачивается вместе со знаком.
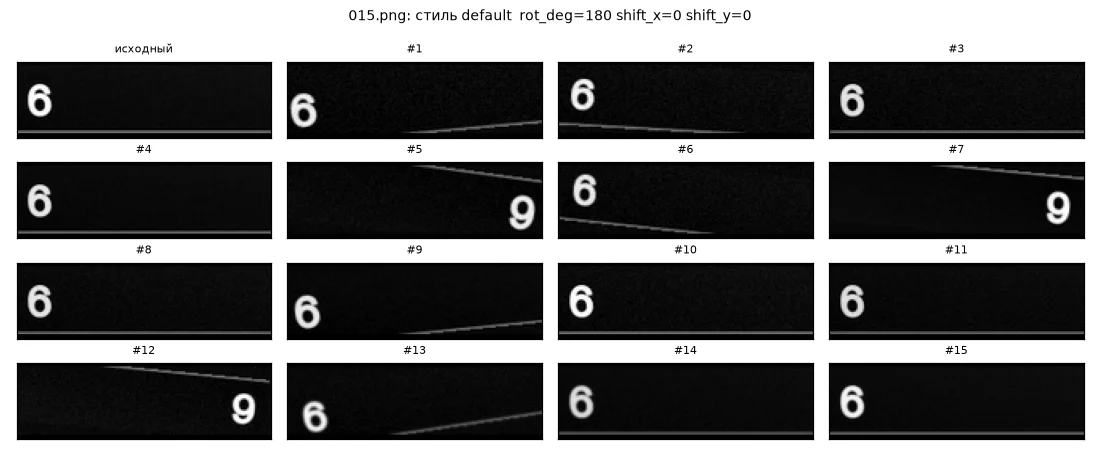
Остальные клетки почти не повернулись. Проверка границ отклоняет поворот, при котором цифра вышла бы за край, и тогда геометрия просто не применяется. Это тоже бережёт метку, но не заменяет лимит в 5°.
--override принимает одно число. rot_deg=10, noise=0.2 и blur_prob=1 подходят. Пару вроде масштаба из командной строки не передать: скрипт делает из значения float, а масштаб в конфиге — это два числа.
Дополнительно увеличьте шум у стиля printed:
python experiments/show_augment_grid.py --find-text 6 --style printed --override noise=0.2Найдите момент, когда цифры перестают читаться глазами. Это верхняя граница для ваших данных. В обучение такое значение не переносите.
Если не так
ValueError: rot_deg=...: поворот больше ±5° не сохраняет меткуили строка «Параметры отклонены» в скрипте сетки. Сработала защита. В обучении лимит не меняют. Для сетки добавьте--unsafe.В data/processed/train.jsonl нет кропа с меткой '...'. Вtrainнет такой строки. Попробуйте6или7.FileNotFoundError: manifest.jsonилиtrain.jsonl. Не сделаны уроки 4–5: сначалаprepare_dataset.pyиsplit_groups.py.ModuleNotFoundError: datasetsилиalphabetпри фрагменте сDataLoader. Команды сетки иpytestсами добавляютsrcв путь. Отдельный файл в корне — нет. Запускайте его какPYTHONPATH=src python ...или из урока, где скрипт лежит вsrc. Если установлен сторонний пакет с тем же именемdatasets, он перехватит импорт. Тогда переименуйте нашу папку, например вcrop_data, и поправьте импорты.ModuleNotFoundError: torchпри вызовеcollate_ctcилиDataLoader. Остальной код урока torch не требует. Установите его по уроку 1. Пропущенный тест загрузчика при этом нормален:18 passed, 1 skipped.--override scale=1.2падает внутриuniform. Скрипт сетки умеет подменять только одно число. Масштаб, пропорции, радиус размытия и качество JPEG — пары. Их задают вAugmentConfig, не флагом.- Обучение упирается в загрузку данных. У
DataLoaderестьnum_workers. Зерно рабочего процесса из урока 1 (seed_worker) и генератор загрузчика оставляют результат повторяемым. - Аугментированные кропы выглядят очень тёмными. Для
printedэто ожидаемо: яркость чернил снижается до 0.55.
Чек-лист
- Шесть файлов урока лежат в вашем репозитории и закоммичены
- Сетки
aug_default.pngиaug_printed.pngпостроены -
pytestпечатает19 passed(или18 passed, 1 skippedбез torch) - С
--unsafeиrot_deg=180видно, что клетки #5, #7 и #12 могут стать девяткой - Три прогноза из «Предскажи» сверены с разделом «Ожидаемое»
FAQ
Почему нельзя просто повернуть кроп на случайный угол до 30°?
Для рукописных букв большой поворот часто безвреден. Для цифр 6 и 9 он меняет ответ. Лимит ±5° оставляет лёгкий наклон скана и не превращает шестёрку в девятку. Сетка с --unsafe как раз показывает, где проходит эта граница.
Зачем два стиля, default и printed?
default — лёгкие сдвиги «от руки». printed имитирует фото печати: бледные чернила, JPEG, шум. В обучении стиль выбирается явно. Отдельную оценку на фото кропах отложим до урока 15.
Почему шум добавляется после autocontrast_safe?
Если зашумить бумагу до растяжения контраста, защита из урока 2 может принять шум за чернила и нарисовать текст на пустой клетке. Геометрия на сером скане этой защите не мешает. Шум на уже готовом холсте — мешал бы, окажись он раньше.
CropDataset не наследует torch.utils.data.Dataset. Это ошибка?
Нет. DataLoader вызывает __len__ и __getitem__. Ядро остаётся на NumPy. torch нужен в to_torch и в тесте загрузчика. Без установленного torch этот тест пропускается, остальные проходят.
Почему пустая клетка в CTC-батче имеет длину цели 0, а не специальный символ?
Пустая строка уже закодирована как пустой список индексов (урок 3). Длина 0 говорит CTC: правильный ответ — пустая последовательность. Отдельный класс «пусто» здесь не нужен. Его роль у детектора, и там пустая клетка — это label 1.
Нужно ли коммитить experiments/aug_*.png?
Нет. Сетки пересобираются скриптом. В репозиторий курса они не входят.
Что дальше
CropDataset впервые используется в следующем уроке: Урок 7. В оглавлении серии он называется Tiny CNN. Там появится первая обучаемая сеть и сравнение с простыми базовыми ответами. Баланс пустых и заполненных кропов — уроки 9 и 13.
Эталон для сверки: lesson-06. Клонировать его не нужно. Предыдущий урок: Урок 5. Деление по листам и утечка.