
Почему модель теряет середину длинного документа
На 500 страницах документации полный контекст дал около 34% точности. Маленькая модель отбирает факты до дорогой.
Новости для разработчиков без шума — My Dev News в Telegram.

Тег
Все статьи блога с этим тегом.
На 500 страницах документации полный контекст дал около 34% точности. Маленькая модель отбирает факты до дорогой.
Как выбрать метрики качества нейросети: классификация, компьютерное зрение, OCR, LLM и RAG, калибровка и производственные показатели — что измерять, чтобы модель реально работала в продукте.
North Small Translate: 218 млрд параметров, 25 млрд активных, 50 языков. WMT26 83,60 и лицензия CC BY-NC — сигнал эпохи узких промышленных моделей.
Qwen 3.8 27B на публичных конечных точках Cerebras: ~1500 токенов/с, 64k/128k контекст, без прореживания в проде.
Как спроектировать локальный контур качественного анализа с Mistral Small 3.1, Ollama и FastAPI — без ложных обещаний ИИ.
MoE на CMP 90HX терпимо, dense — нет: карта ограничена по типам вычислений. Модификация драйвера через V67 даёт почти ×2, но не снимает все ограничения.
Как текст становится токенами и векторами, что делает Transformer, чем обучение отличается от RAG, и как из Markdown собрать поиск знаний для модели.
Сначала продуктовое решение и ограничители, потом модель: офлайн-оценка как интеграционные тесты и разбор ошибок.
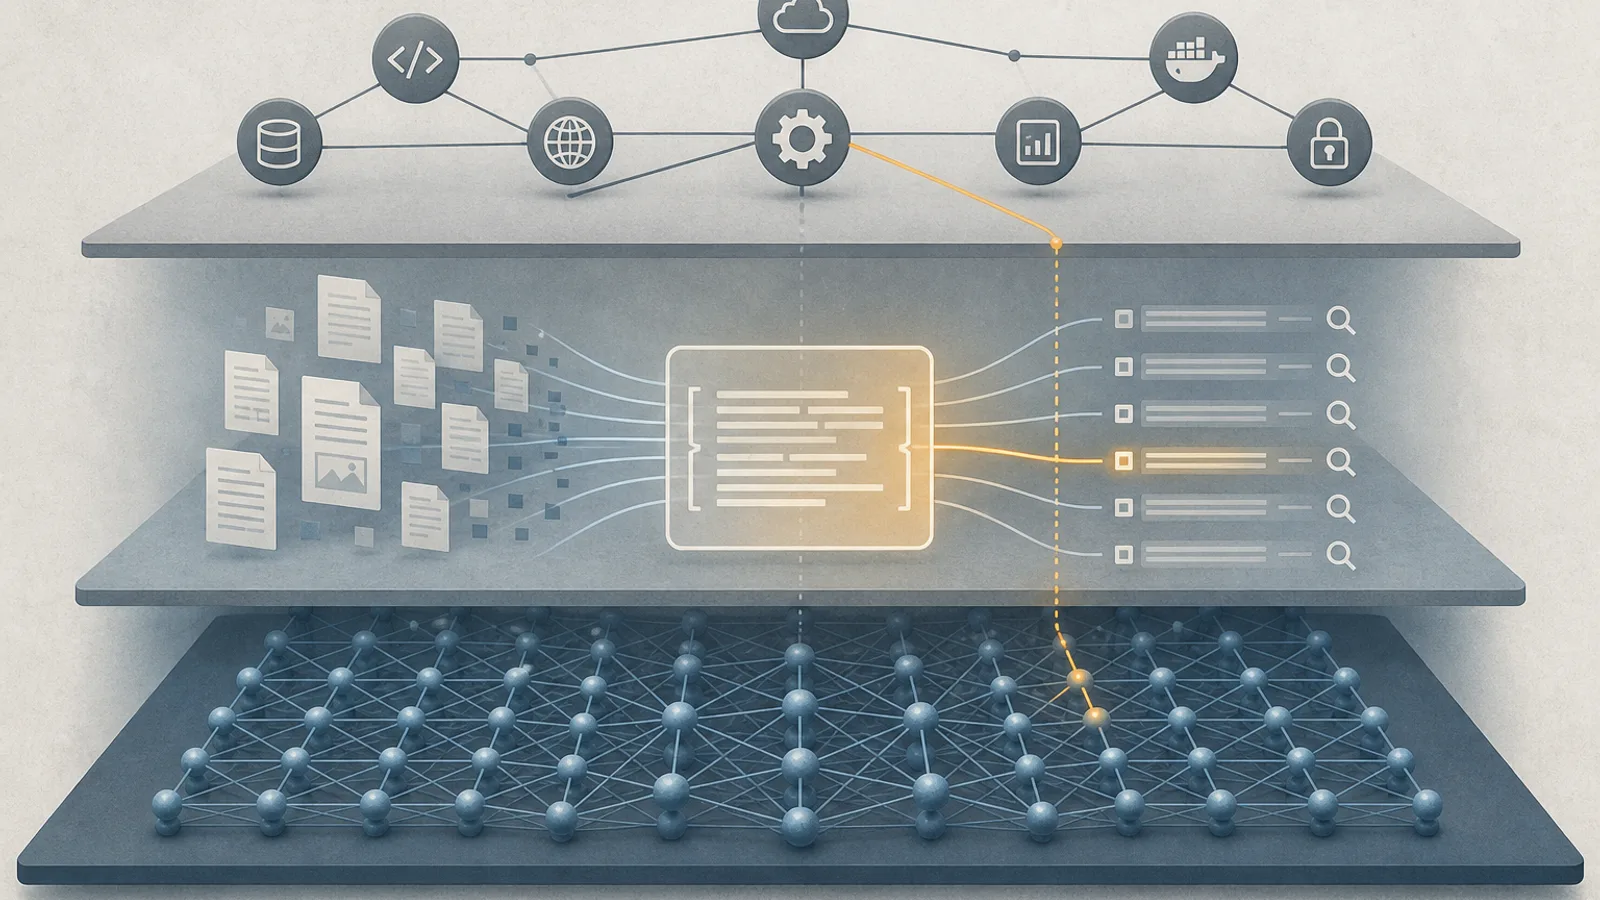
Уровни адаптации языковых моделей: что меняет веса, что подключает знания и инструменты, и как выбрать подход без «дообучения на PDF».
Минцифры, УКУ и lang-uk открыли на Hugging Face открытый рейтинг LLM по украинскому: перевод, пересказ, поиск, логика, ЗНО.
Почему облегчённые модели плодят вызовы инструментов, как бенчмарки врут и какие метрики считать вместо цены за миллион токенов.
Prime Intellect сравнил 18 моделей на `nanoGPT`: лучший валидированный счёт у Kimi K3kimi-code, плюс 41 полная траектория агента.
Стенд на vLLM и Blackwell: hit rate кэша 96,9%, отношение вход/выход 452:1 и почему свой контур берут не ради экономии.
Виды проверок LLM: открытые наборы задач, арены, модель-судья, безопасность, регрессия продукта и онлайн-сигналы — что каждый тест проверяет и чего не видит.
Четвёртая часть серии про автодополнение: Language Server Protocol даёт типы, определения и ссылки — слой поверх текстового поиска по репозиторию.
Anthropic публикует system prompts: не «магические» роли, а правила решений, инструментов, неопределённости и UX длинных агентных задач.

Контрпримеры и доказательства от моделей, побег из песочницы, сертификаты Lean: не путать цепочку рассуждений с верным выводом.

Как спроектировать шлюз ИИ с маршрутизацией моделей, бюджетами токенов и контролем стоимости: политики, кэш, отказоустойчивость и юнит-экономика без потери качества ответов.

Национальная научная инициатива OpenAI даст лабораториям и университетам доступ к моделям, но решающими остаются проверка и контроль.

Moonshot AI открыла веса Kimi K3: как устроена MoE-модель, почему 1,4 ТБ меняют планы развёртывания и что проверить в лицензии.

Как выбрать языковую модель для корпоративного ИИ по сценариям, безопасности, стоимости и требованиям к инфраструктуре.

Как запускать открытые LLM в продакшене: управлять инференсом, выбирать модели по задачам и гарантировать формат ответов.

Colibri запускает GLM-5.2 MoE без GPU: постоянная часть в ОЗУ, эксперты на NVMe. Разбираем подход, скорость и реальные сценарии.

Тестовая MiMo-V2-Pro под именем Hunter Alpha собрала триллион токенов: решающими оказались качество, цена и ограничения для данных.

Как ограничения поиска и экспертных систем привели к LLM и почему модель — интерфейс к знаниям, а не корпоративная память.

Разбор подхода с Claude Desktop, DuckDB и песочницей: расчёты выполняют инструменты, а ИИ получает схему данных и строгие ограничения.
Эксперимент с домашним чат-ботом: как дообучить крошечную локальную LLM через Unsloth и двухбуквенные коды категорий вместо имён меток.