
Семь дыр, которые ИИ чаще вставляет в код — и как их ловить
Почему ассистенты генерируют «правдоподобный пример», а не прод: секреты в коде, SQL-склейка, дыры в доступе. Таксономия и сканер ai-vuln-scan.
Новости для разработчиков без шума — My Dev News в Telegram.

Тег
Все статьи блога с этим тегом.
Почему ассистенты генерируют «правдоподобный пример», а не прод: секреты в коде, SQL-склейка, дыры в доступе. Таксономия и сканер ai-vuln-scan.
Разбор Voodoo.js изнутри: от DOM после HTML-разборщика браузера до лексера, дерева выражений, интерпретатора, эффектов через Proxy и прямой записи в узлы без eval.
Права доступа в промышленном RAG нельзя оставлять модели. Как изолировать арендаторов, применить список доступа до извлечения, закрыть скрытые каналы утечки и измерить полноту при жёстких фильтрах.
Сначала продуктовое решение и ограничители, потом модель: офлайн-оценка как интеграционные тесты и разбор ошибок.

Объём агентных запросов на слияние превышает ёмкость ревью: долг проверки, границы человека и модели, контрольный список после разницы изменений, человеческие шлюзы и правила команды для лёгкого и глубокого ревью в 2026.

Практическая модель агентной разработки: контекст, декомпозиция задач, циклы проверки, многоагентная оркестрация, безопасность, метрики и роль инженера в жизненном цикле разработки 2026 года.

Практическая модель вывода ИИ-агентов и RAG-систем в промышленную эксплуатацию: политики как код, узкие права инструментов, согласования человеком, проверка атак и аудит, пригодный для разбора инцидентов.

Практическая архитектура защиты от промпт-инъекций в RAG и агентных системах: происхождение документов, изоляция контекста, минимальные полномочия, контроль исходящего трафика, песочницы и проверяемая многоуровневая защита.

Практический разбор Model Context Protocol после релиза 2026-07-28: отказ от сессий, MRTR, маршрутизация по заголовкам, авторизация, shadow MCP и как писать серверы, которые переживают нагрузку.

Как объединить бизнес-задачи, знания, RAG, агентов, безопасность и наблюдаемость в устойчивую корпоративную ИИ-платформу.

CVE-2026-7482 в Ollama показывает: локальная LLM может раскрыть память процесса, если сервер доступен из сети и принимает недоверенные модели.

Какие архитектурные ошибки подрывают корпоративные ИИ-платформы и как предотвратить их до промышленного запуска.

Как расширять корпоративную ИИ-платформу на уровень холдинга, сохраняя единые стандарты, локальные границы данных и управляемую архитектуру.

Как выстроить безопасный жизненный цикл изменений в корпоративной ИИ-платформе: от требований и тестов до выпуска, отката и мониторинга.

Как организовать наблюдаемость корпоративного ИИ: от инфраструктуры и RAG до безопасности, качества ответов и бизнес-метрик.

Как измерять качество корпоративного ИИ по поиску, ответам, безопасности и влиянию на бизнес-процессы.

Как спроектировать масштабируемый RAG для множества источников, миллионов документов и разграничения доступа.

Как очистить, описать, разбить и безопасно индексировать корпоративные документы для качественных ответов ИИ.

Как выбрать серверы, ускорители, сеть и хранилище для корпоративной ИИ-платформы без избыточных закупок.

Как выбрать языковую модель для корпоративного ИИ по сценариям, безопасности, стоимости и требованиям к инфраструктуре.

Как спроектировать масштабируемую платформу корпоративного ИИ, где знания, безопасность и интеграции важнее отдельных моделей.

Как выбрать ограниченный и безопасный пилот корпоративного ИИ, определить критерии успеха и подготовить масштабирование.

Как выявить, классифицировать и безопасно подключать знания предприятия для RAG и корпоративного поиска.

Как провести интервью, проанализировать процессы и выявить источники знаний до проектирования корпоративного ИИ.

Почему проект корпоративного ИИ начинается с бизнес-задач, знаний и безопасности, а не с выбора модели или серверов.

Как построить корпоративную ИИ-платформу, которая переживет смену моделей, поставщиков и форматов данных.

Почему корпоративный ИИ внедряют через пилоты, обучение и обратную связь, а не одномоментным запуском по всей организации.

Как распределить ответственность, контролировать изменения и обеспечить качество и безопасность корпоративной ИИ-платформы.

Как связать корпоративный ИИ с ERP, сохранив ERP источником достоверных данных, роли доступа и контроль операций.

Как агентные системы связывают языковую модель с корпоративными сервисами и автоматизируют процессы под контролем человека.

Как отличить задачи корпоративных знаний от задач поведения модели и понять, когда дообучение оправдано.

Почему защита данных, права доступа, проверяемость ответов и аудит должны определять архитектуру корпоративного ИИ с первого дня.

Как спроектировать надежную и масштабируемую инфраструктуру корпоративного ИИ, начиная с бизнес-сценариев и требований безопасности.

Как векторная база ускоряет поиск по знаниям предприятия, сохраняет права доступа и становится частью надежной RAG-архитектуры.

Как векторные представления помогают находить корпоративные знания по смыслу, не отменяя точный поиск и требования безопасности.

Как RAG отделяет корпоративные знания от модели, поддерживает актуальность документов и сохраняет проверяемый доступ.

Как ограничения поиска и экспертных систем привели к LLM и почему модель — интерфейс к знаниям, а не корпоративная память.

Как построить корпоративную ИИ-платформу вокруг слоя знаний, интеграций и безопасности, не привязываясь к одной модели.

Почему корпоративный ИИ начинают с измеримой бизнес-задачи, знаний и безопасности, а не с выбора модели.

Почему знания — стратегический актив, а корпоративный ИИ проектируют от бизнес-задачи и безопасности, а не от выбора LLM.
Staged publishing в npm и pnpm 11.3 снижает риск supply chain: сначала черновик на registry, проверка, потом «прод». Плюс trustLockfile и npm 12 prerelease.
Конкатенация, шаблонные строки и «безопасная» переменная sql — почему ревью пропускает уязвимости и как ловить их eslint-plugin-pg.
40% команд называют безопасность главным барьером масштабирования agentic AI. Docker Sandboxes, seccomp и изоляция автономного кода.
Мониторинг с кластеризацией ловит распределённые атаки на 30% быстрее стандартных методов.
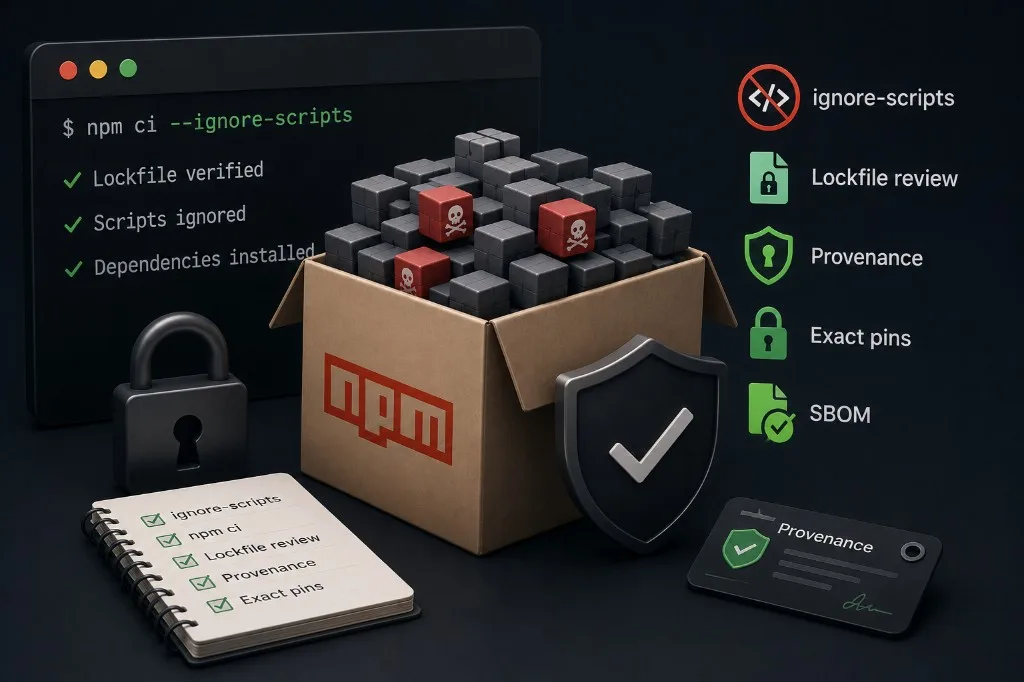
ignore-scripts, npm ci, provenance и аудит lockfile — слоистая защита, когда в node_modules тысячи транзитивных пакетов.